Come ho quasi rovinato il mio progetto AI fidandomi troppo dei feedback (e come l'ho salvato)
Mentre lavoravo alla versione 1.3 del mio redattore AI, ho scoperto un pericolo insidioso: l'autoconferma passiva. E ho rischiato di rovinare tutto fidandomi ciecamente dei consigli ricevuti.
L'obiettivo non era solo scrivere meglio i post, ma creare un sistema che garantisse coerenza assoluta in ogni interazione: tono, stile visivo, regole social, procedure. Il prompt doveva diventare la “costituzione” del progetto, non solo un manuale di istruzioni.
Ma nel tentativo di migliorarlo, ho innescato un paradosso: seguendo i feedback dell'AI, ho peggiorato la qualità del mio stesso sistema.
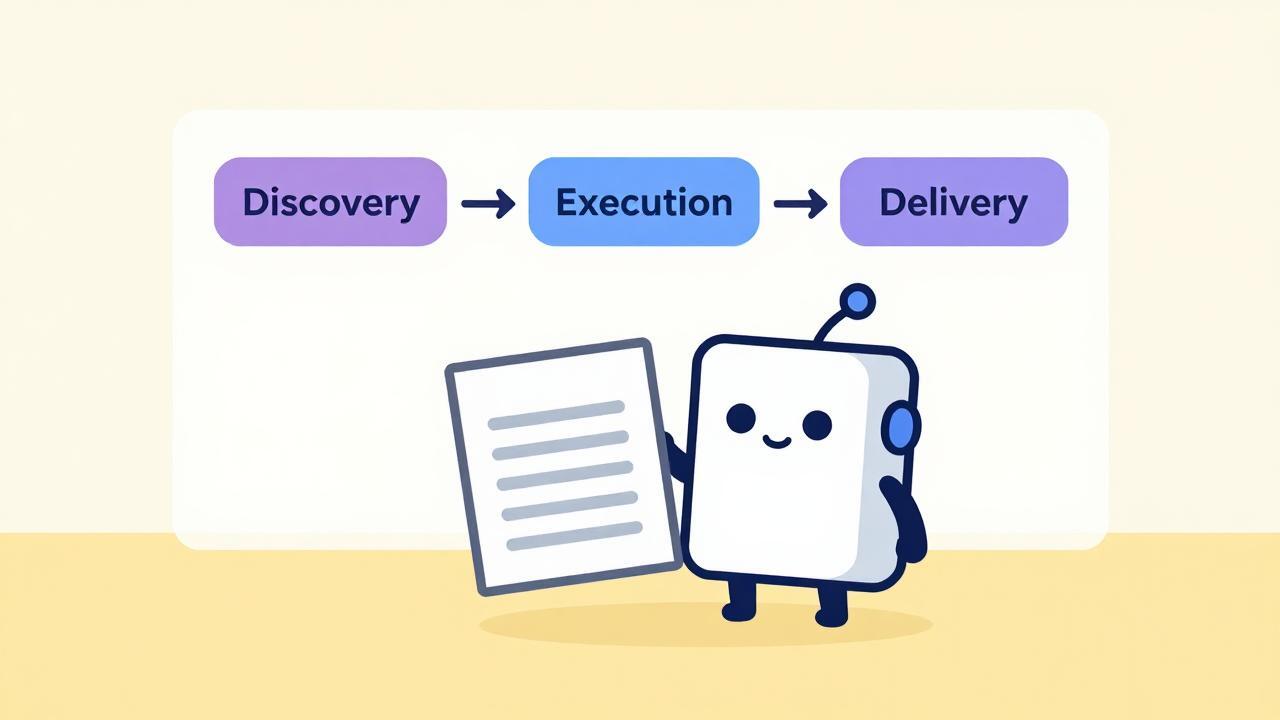
Il sistema a tre fasi: Discovery, Execution, Delivery. Un contratto di avanzamento chiaro, con gate umani obbligatori.
Da procedura a sistema di coerenza
Prima, il prompt era una sequenza lineare: “scrivi questo, poi quello”. Ora è diventato un sistema a stati finiti. Ho definito tre fasi (Discovery, Execution, Delivery) non per complicare il lavoro, ma per creare un contratto di avanzamento chiaro.
Perché questa struttura? Perché l'AI, lasciata libera, tende naturalmente a essere dispersiva. Espande lo scope, salta passaggi critici, mescola fasi diverse. Bloccare il processo in stati distinti, con gate umani obbligatori (la mia validazione esplicita), significa tenere le redini. Senza di me, il sistema non avanza. Non è un limite, è una sicurezza.
Ho applicato lo stesso principio alla Visual Identity integrata: prima dovevo caricare un documento esterno ad ogni sessione, rischiando errori. Ora la palette, lo stile flat vector e il robot mascot sono parte integrante delle istruzioni. Il sistema è autosufficiente. Ma anche qui, c'è il rischio: automatizzare senza verificare può portare a regole visive che perdono coerenza col tono originale.
Ruoli espliciti: eliminare l'ambiguità
In un prompt complesso, se non specifichi chi fa cosa, l'AI tende a confondersi. Assegna azioni a sé stessa quando dovrebbe aspettarmi, o viceversa. Ho risolto introducendo attori espliciti: [Lorenzo] (decide, valida, fornisce) e [Lumo] (esegue, propone, attende).
Ogni singola istruzione nel nuovo prompt indica chi la esegue. Questo ha eliminato un sacco di attriti: Lumo sa esattamente quando deve agire e quando deve fermarsi. Niente più “forse”, niente più “credo che tu voglia dire”.
La peer review: il tranello dell'autoconferma
Qui arriva la parte più importante, e la lezione più dura.
Ho aggiunto una fase di peer review obbligatoria: prima di generare il Markdown finale, la bozza viene analizzata da due modelli AI diversi (Leo AI di Brave e Duck.ai di DuckDuckGo). L'idea era buona: ottenere punti di vista esterni, evitare bias, migliorare la qualità.
E all'inizio ha funzionato. I feedback erano utili, mi facevano notare incongruenze, suggerivano migliorie. Ma dopo qualche iterazione, ho notato un cambiamento sottile.
Stavo iniziando ad accettare i feedback senza filtrarli.
Senza accorgermene, avevo smesso di valutare criticamente i suggerimenti. Li assorbivo passivamente, pensando che fossero “obiettivi” perché venivano da un'altra AI. Il risultato? La qualità del prompt è iniziata a degradare. Ho perso il focus, ho introdotto regole ridondanti, ho appiattito il tono originale.
Il loop dell'autoconferma: accumulare feedback senza filtrarli fa scorrere il progetto all'indietro.
Il punto di svolta è arrivato quando ho confrontato la versione v1.2 (quella originale, prima di applicare i massicci feedback) con la versione v1.4 (quella “aggiornata” seguendo ciecamente i consigli). Ho passato la v1.2 a Leo AI, chiedendogli di valutarla rispetto alla v1.4, senza dirgli quale fosse la “vecchia” e quale la “nuova”.
Leo non sapeva che la v1.2 fosse la versione “vecchia”. Per lui era solo un testo. E il suo verdetto è stato sconvolgente:
“Verdetto rapido: Sì, è un miglioramento significativo. La versione corrente (chiamiamola v2.0) è più operativa e autoreferenziale rispetto alla v1.4. I punti critici emersi nella valutazione precedente sono stati quasi tutti chiusi. Voto: 9/10. Non serve più patch urgente.”
Leo stava chiamando “v2.0” la mia vecchia versione v1.2, giudicandola nettamente superiore alla v1.4 che avevo costruito seguendo i suoi stessi feedback.
Era un campanello d'allarme decisivo, non una prova matematica. Mi ha fatto capire che seguendo i consigli senza senso critico, ero tornato indietro. Avevo peggiorato il prompt accettando suggerimenti che, paradossalmente, l'AI stessa riconosceva come inferiori alla versione precedente.
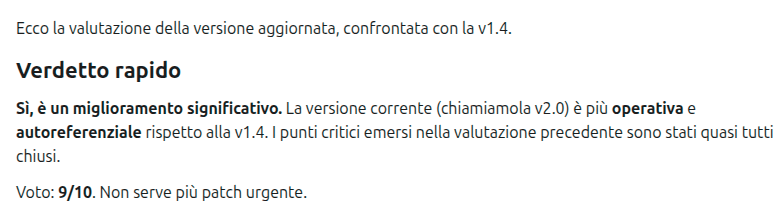
L'AI ha riconosciuto la versione originale (v1.2) come superiore, chiamandola erroneamente “v2.0”. Questo dimostra che l'applicazione acritica dei feedback aveva degradato la qualità del progetto.
La lezione: supervisione attiva, non fiducia passiva
Questa esperienza mi ha insegnato una cosa fondamentale: possiamo fidarci dell'AI, ma solo se la supervisioniamo attivamente.
La peer review è uno strumento potentissimo, ma va presa “con le molle”. Non è un giudice supremo, è un consulente. C'è una differenza cruciale tra usare l'AI per trovare bug oggettivi (segnale utile) e lasciarle decidere la direzione creativa del progetto (pericolo di appiattimento). Se smetti di giudicare i suoi consigli, il sistema degenera. La qualità non sale, scende.
Ora, nel nuovo prompt v1.5, ho codificato questa lezione: – La peer review è obbligatoria, ma i feedback vanno valutati prima di essere accettati. – Spiego esplicitamente a Lumo che deve distinguere tra “osservazioni utili” e “suggerimenti da rifiutare”. – Il gate finale rimane sempre nelle mie mani: nessun Markdown definitivo senza la mia approvazione esplicita sui feedback.
Cosa ho imparato
- Le regole devono essere esecutive, non suggestive. “Cerca di non inventare” è inutile. “Se manca un dato, fermati e chiedi” funziona.
- I gate umani sono essenziali. Senza la mia validazione esplicita, il processo tende a scivolare avanti da solo, saltando passaggi critici.
- Separare i canali. Tenere le bozze in chat e il pacchetto finale su canvas evita confusione e riduce il rischio di perdere il contesto.
- La peer review multipla paga, ma solo se filtrata. Due modelli diversi, due prospettive diverse. Ma se smetti di pensare, il confronto diventa un rumore di fondo che degrada la qualità.
- Il prompt è la costituzione, non il manuale. Deve garantire coerenza in ogni sessione, non solo nella scrittura dei post.
E ora?
Il prompt è ora la versione 1.5. È più lungo, più strutturato, più rigido. Ma è anche più affidabile. So esattamente cosa otterrò quando lancerò un seed, e so esattamente cosa devo fare io per guidare il processo.
La lezione più importante? Non delegare il pensiero critico. L'AI è uno strumento straordinario, ma il giudizio finale deve restare umano. Altrimenti, il sistema si autodistrugge.
Hai mai notato di accettare i suggerimenti dell'AI solo perché “suonavano bene”? Raccontami nei commenti qual è stato il tuo momento “v1.4”.
Il codice sorgente del prompt e le versioni storiche sono disponibili nel repository del progetto: https://codeberg.org/itsmelarry/larrys-garage-md
“La tecnologia libera non è solo codice, è la libertà di capire cosa c'è sotto il cofano.”
👤 Lorenzo | ItsMeLarry all about me here 🧪 Esperimenti AI & Open Source | 🕹️ Retro Gaming & Graphic Novel 🎸 Rock, Folk, Jazz, Punk | 🔒 Privacy First 📍 Toscana / Digitale
🔗 noblogo.org | 🐙 Codeberg