La GPU che non sapeva di potercela fare: da 5 a 13 token/s senza comprare niente
Ho passato una serata a scoprire che la GPU del mio mini-PC aveva riserve di velocità che non usava. Che un mio benchmark, fatto male, mi ha dato un verdetto sbagliato. E che alla fine l'AI di casa gira al doppio della velocità senza aver speso un euro. Resoconto di com'è andata.
Nota: il “da 5 a 13” del titolo è l'avventura di oggi, il modello che usavo prima aveva una velocità di 5 token/secondo, quello che uso ora di 13. Mi sono dedicato all'ottimizzazione partendo da un confronto alla pari, stesso modello con backend diverso, è tutto nella tabella più sotto.
Preciso prima di cominciare: non sono programmatore né ho formazione tecnica. Tutto quello che faccio — configurare server, compilare codice, gestire backend — lo faccio lavorando fianco a fianco con assistenti AI. Non copio istruzioni a caso: seguo una logica, chiedo spiegazioni, provo e riprovo. Questo post non è la testimonianza di uno specialista. È il resoconto di chi ha imparato a navigare in territori tecnici con un copilota digitale.
Prima di tutto: i token
Quando un'AI scrive, non produce parole intere ma token: pezzi di parole, di lunghezza variabile. I “token al secondo” (t/s) sono quindi la velocità con cui il modello genera la risposta: a 5 t/s la risposta arriva a passo di lumaca, a 13 t/s pare qualcuno che digita velocemente.
C'è però anche l'altro verso, quello che si vede meno. Prima di rispondere, il modello deve leggere quello che gli hai scritto, e anche la lettura ha una sua velocità (il prompt processing, i token in ingresso). Se il modello legge lento, l'attesa davanti al cursore che pulsa si allunga. Nel mio caso capitavano attese di diversi secondi prima ancora che iniziasse a rispondere.
Il mio problema era la generazione: cinque token al secondo sul modello che uso tutti i giorni.
Il punto di partenza: 5 token al secondo sul modello che usavo ogni giorno. Lento, fastidioso, e con una GPU che non sapeva ancora di potercela fare.
Il mistero della GPU
Cinque token al secondo sono pochi, ma la domanda da farsi per capire come velocizzare le risposte è dove viene eseguito il calcolo di quale token restituire e come. Un'AI genera token uno alla volta, e ogni token è il risultato di una catena di moltiplicazioni su numeri enormi. Qualcuno deve fare quei calcoli: la CPU o la GPU? E se è la GPU, li fa davvero o si limita a tenere il modello in memoria?
La mia prima ipotesi, quella ovvia: “starà girando in CPU, povera GPU”. Controllo i log di Ollama e la risposta è no. La GPU Arc integrata nel mio mini-PC era stata trovata, il modello mistral-nemo:12b era stato caricato per intero. La GPU lavorava. Era solo lenta.
Resta il come. E qui l'indagine cambia: non più l'hardware, ma il software che gli dice cosa fare. Una GPU non capisce un modello AI da sola, qualcuno deve tradurglielo. Quel qualcuno è il backend.
E da ora in poi la serata degenera, nel senso buono.
Il backend è un traduttore
Una GPU non capisce i modelli AI direttamente: serve un pezzo di software che prende i calcoli del modello e li traduce in istruzioni eseguibili dalla GPU. Questo traduttore si chiama backend.
Nella mia configurazione, Ollama — il programma che gestisce i miei modelli — usa con le GPU Intel un backend chiamato Vulkan: un traduttore generico, che parla la lingua comune della GPU.
Il punto è che le GPU Intel Arc recenti contengono, sulla carta, delle unità specializzate, le XMX, progettate per moltiplicare matrici, cosa che è letteralmente il mestiere dell'AI. Far girare un modello senza usarle è come avere un forno professionale in cucina e cucinare col microonde. Nel mio caso, con Vulkan, quel guadagno non arrivava.
Esiste però un altro backend, SYCL — uno standard aperto del gruppo Khronos, con implementazioni per le GPU Intel basate su oneAPI, la libreria di Intel stessa — che quelle unità, in teoria, le sfrutta. Valeva la pena di verificare.
(Avevo valutato anche LM Studio come alternativa. Poi ho capito che, per quanto ne so, sotto il cofano usa anch'esso Vulkan: cambiare la scatola non cambia il motore.)
Il benchmark che ho fatto male
Installo il toolkit oneAPI, compilo llama.cpp col backend SYCL, faccio il primo benchmark: 5,97 t/s. Circa 0,7 token in più rispetto a prima. Un guadagno che non giustificava lo sforzo di compilazione e configurazione. Verdetto affrettato: “SYCL non conviene”.
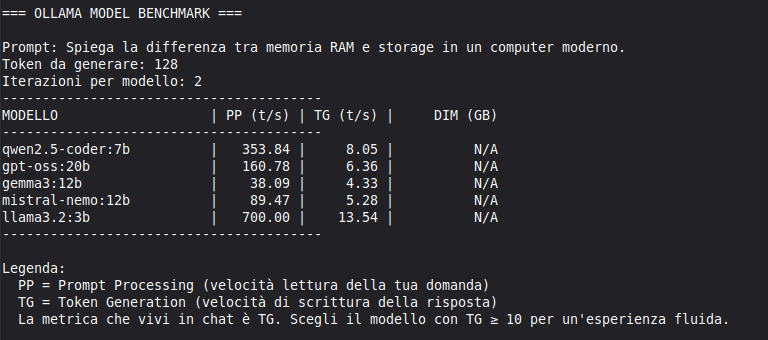
Peccato che il benchmark fosse sbagliato: mentre misuravo, Ollama era ancora acceso con i suoi modelli caricati in GPU, a contendersi memoria e banda. Era come misurare le performance di una macchina mentre stai dando un passaggio a un elefante sul sedile del passeggero. E l'impronta era lì, nei numeri: la misura oscillava di ± 2 t/s da una run all'altra, un'instabilità che con la GPU libera non c'era.
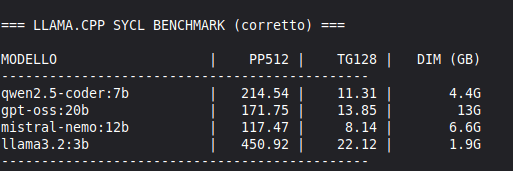
Se vuoi misurare correttamente, spegni tutto quello che non stai misurando.
E quindi ecco la velocità misurata di nuovo, a GPU libera:
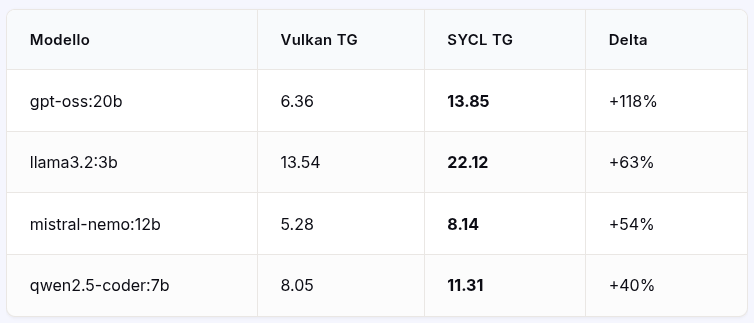
Per quanto ho potuto, ho tenuto tutto uguale: stesso file GGUF (che contiene il modello), stessa GPU, stessa lunghezza di input. La differenza vera sta nel backend. Metodologia: stesso prompt e 128 token generati per iterazione, due iterazioni per modello da entrambi i lati; SYCL misurato con llama-bench (due esecuzioni coerenti fra loro), Vulkan tramite l'API di Ollama. Guadagni dal +40% al +118%.
Ma la tabella conta solo la scrittura. Sulla lettura del prompt la classifica si ribalta: Vulkan resta davanti — il modello più piccolo, per dire, viene letto a 700 t/s contro 451 t/s di SYCL. Il trade-off, nel concreto: SYCL vince in generazione, perde qualche secondo iniziale quando il contesto è enorme. Nel mio uso quotidiano, fatto di domande corte, il primo conto è quello che pesa.
Il benchmark alla pari: stessa GPU, stesso file di modello, backend diverso. Il verdetto era scritto già nella prima misura, quella instabile: l'elefante era seduto lì.
Metterlo in piedi: tre incidenti e tre rimedi
Portare il tutto in produzione non è stato subito indolore. Tre episodi, tre rimedi.
Il servizio systemd che gestisce i servizi su Linux non faceva partire nulla: a runtime mancava libdnnl.so.3 — le librerie Intel stanno in cartelle (/opt/intel/oneapi/...) che systemd non guarda. Rimedio: uno script di avvio che carica l'ambiente oneAPI e poi lancia il server.
Poi la porta di default era già occupata da un altro servizio del mini-PC (Sentinelle di Casa). Spostato tutto alla 8090.
Infine la chat rispondeva a vanvera, monologhi in inglese fuori contesto. Il problema era il chat template, cioè il copione che dice al modello come funziona una conversazione. Ollama lo tiene archiviato per conto suo, fuori dal file del modello, e glielo passa quando serve. Il nuovo server invece prendeva il file al volo, nudo e senza copione: da lì i monologhi. Rimedio: un flag, --chat-template gpt-oss, che glielo mette in mano.
Com'è configurato adesso
Interfaccia invariata (Open WebUI, con Ollama come default al boot e il server SYCL acceso a richiesta, cambiando connessione), modelli condivisi su disco fra i due servizi per poter cambiare il backend senza duplicare i file.
Cosa ho imparato
Primo: spegni ogni cosa prima di misurare qualcosa. Il verdetto che mi aveva quasi fatto abbandonare era colpa della mia metodologia, non della tecnologia.
Secondo: il margine di miglioramento stava nel backend, non nella scatola. Il salto l'ha fatto il traduttore, non il programma che lo contiene.
Terzo: la mia iGPU Arc aveva capacità non sfruttate, non perché fosse ferma, ma perché lo strumento standard non le usava. Andarsi a leggere come funziona davvero la propria GPU costa una sera di compilazioni, meno di un componente nuovo.
Morale
Morale della serata: a volte una GPU lenta non ha bisogno di un hardware nuovo, ma solo di qualcuno che le parli nel modo giusto. Da parte mia il mio mini-PC parla al doppio della velocità di ieri, e io non ho dovuto comprare nulla. Ho solo pagato in milioni di token di conversazione con un assistente AI, ma quelli li avevo già in abbondanza.
“La tecnologia libera non è solo codice, è la libertà di capire cosa c'è sotto il cofano.”
👤 Lorenzo | ItsMeLarry all about me here 🧪 Esperimenti AI & Open Source | 🕹️ Retro Gaming & Graphic Novel 🎸 Rock, Folk, Jazz, Punk | 🔒 Privacy First 📍 Toscana / Digitale
🔗 noblogo.org | 🐙 Codeberg