Larry's Garage

Un viaggio assistito di introspezione tecnologica autonoma

Come ho portato lo sviluppo su specifiche delle Sentinelle di Casa dal cloud alla mia LAN — e cosa ho capito quando l'agente diceva di scrivere ma non scriveva.
La nuvola resta fuori dal perimetro: i modelli girano in casa.

Ho scritto la documentazione OpenSpec delle feature delle “Sentinelle di Casa” con modelli che girano dentro casa: nessun file del repository è uscito dalla mia LAN in quella fase. Il codice che quelle specifiche documentano, invece, era nato prima nel cloud — e questa storia comincia proprio lì. Per farlo ho messo in fila tre servizi AI diversi e almeno otto modelli linguistici. Il primo file scritto in locale è arrivato alla fine di una serata in cui ho litigato con un agente che parlava benissimo di modifiche che non faceva.

Questa è la storia di quella serata.

Da dove arrivo

Riassunto per chi non ha letto il post precedente: la notte del 25 ottobre 2026 un blackout ha spento tre nodi della mia rete domestica e nessuno si è riavviato da solo. Dal fastidio di quell'evento è nato un sistema distribuito di monitoraggio — sentinelle che pubblicano heartbeat su MQTT, un collector che archivia in SQLite, una dashboard che racconta lo stato della casa.

Non so programmare, e il codice di quel sistema è nato con Lumo, via interfaccia web. Io descrivevo, l'assistente generava file di codice e markdown, e io copiavo il codice a mano, dai tab delle creazioni di Lumo al computer su cui doveva girare. Funzionava. Ma il passaggio umano era obbligatorio, e tutto avveniva via web.

Il metodo però, quello, era già quello giusto: usavo il ciclo di definizione e validazione delle specifiche di OpenSpec.

Il giro circolare

L'esperimento di questa serata è stato provare a chiudere il cerchio dentro la LAN. Il risultato è un flusso che mi diverte molto perché è circolare e non ha un solo padrone:

  1. Lumo (con modelli utilizzati via interfaccia web) ha generato la base: codice e markdown delle Sentinelle.
  2. Copilot in VS Code (con gli agenti che orchestra) mi ha fatto da cicerone: mi ha aiutato a configurare l'editor e a mettere in piedi Continue. L'ho usato solo per le configurazioni di VS Code, dicendogli espressamente di non modificare o leggere il codice nei repository (in pratica l'ho usato per aiutarmi a sostituirlo).
  3. Continue (versione 2.0.0), puntato sui modelli serviti da Ollama su geekmonio nella mia rete locale, legge il codice nel repository e scrive la documentazione OpenSpec delle specifiche, feature per feature, senza far passare il codice per sistemi esterni.

I modelli locali che ho sulla mia macchina dedicata alle inferenze sono cinque: GPT-OSS 20B, Qwen 2.5 Coder 7B, Mistral Nemo 12B, Llama 3.2 3B e Gemma 3 12B. A questi si sommano quelli di Copilot, quelli di Lumo e — per qualche correzione di codice — quelli di Leo AI di Brave.

Ognuno dei modelli locali ha uno scopo preciso: chat, scrittura di codice, orchestrazione degli agenti o autocompletamento.

Ho scelto Leo AI di Brave per le correzioni di codice per quello che Brave dichiara sulla privacy: che le conversazioni con Leo non vengono conservate, condivise né usate per addestrare i modelli, e che non serve un account. Non ho verificato la cosa di persona: mi baso sulla loro dichiarazione, che è il massimo che posso fare come utente. Per me era una scelta coerente con il tipo di dati e di attività che gli affidavo.

Allo stesso modo, con GitHub Copilot ho posto un vincolo esplicito: non leggere o modificare il repository, ma intervenire solo sulle configurazioni di VS Code. Il mio criterio personale, per questo progetto, è questo: usare servizi cloud solo quando la riservatezza è parte dei termini del servizio che sto usando — e mai per il codice del repository.

Facendo il conto: tre servizi AI nel percorso principale, e almeno otto modelli linguistici — cinque locali certificati, gli altri contati per affidamento, uno per servizio. Leo AI è fuori dal percorso principale: entra solo per revisioni.

L'istanza Ollama gira su geekmonio, la macchina nella mia LAN che fa da hub alla rete delle sentinelle, sulla porta 11434 che era già lì prima. Durante la generazione della documentazione, nessun dato del repository è stato inviato a servizi esterni.

OpenSpec l'ho inizializzato nella root del repository: configurazione in openspec/config.yaml, schema spec-driven, e sei prompt pronti in .continue/prompts/ — /opsx-explore, /opsx-propose, /opsx-apply, /opsx-update, /opsx-sync, /opsx-archive. openspec validate --all è passato al primo colpo. Cosa abbia effettivamente verificato con un registro ancora vuoto, onestamente, non l'ho indagato. La CLI sta in ~/.local/bin/openspec e non ha bisogno di Node.js.

Fin qui la teoria. Poi ho provato a far scrivere qualcosa perché, seppure avessi generato il codice seguendo il ciclo OpenSpec su Lumo, non avevo documentato le singole feature.

La documentazione delle singole feature serve perché, con le feature documentate, è possibile definirne di nuove e generare codice nuovo senza modificare il comportamento del software già rilasciato (come era successo nel mio esperimento con la centralina meteo, raccontato nel post qui, con i widget degli agenti sui nodi che restituivano le informazioni sui nodi).

L'agente che parlava benissimo

Obiettivo dichiarato: una modifica minima al README del repository. Una nota che dicesse che la documentazione del progetto è mantenuta con GPT-OSS self-hosted. Roba da trenta secondi, in teoria.

Modalità Agent, modello Geekmonio GPT-OSS 20B, chat nuova. Chiedo la modifica.

L'agente risponde. Parla di strumenti, nomina edit_file, spiega cosa farebbe, a tratti dichiara di non avere accesso a strumenti di modifica. Il README, nel frattempo, resta esattamente com'era.

Il dettaglio che mi ha fatto perdere mezz'ora: nessuna di quelle risposte era un evento. Erano testo in chat. Il modello raccontava di usare strumenti, non li stava usando. E io stavo leggendo la trascrizione di un monologo teatrale credendo di leggere un log.
Dice di aver fatto. Il file dice altro. I log dicono la verità.

La temperatura non bastava come colpevole

Prima ipotesi, la più comoda: il modello è piccolo, la temperatura è troppo elevata e il modello inventa quando non sa, GPT-OSS 20B non è fatto per gli agenti. Ipotesi sbagliata, e lo dico perché all'inizio ne ero proprio convinto.

Guardando meglio la sessione, i problemi erano tre, molto banali, e nessuno riguardava i parametri di sampling:

  • Il workspace era la cartella sbagliata. Continue risultava collegato alla cartella padre del repository, non alla root. Percorsi ambigui, contesto ambiguo.
  • Gli strumenti chiamati non esistevano. L'agente ha provato read_file con un argomento che Continue ha rifiutato, poi readdir, che Continue non riconosce propriamente. Continue documenta read_file, ls, create_new_file ed edit_existing_file: non file_read, non file_write, non readdir.
  • Tool call fantasma. Il modello descriveva l'azione invece di compierla. E il fatto che grep_search funzionasse regolarmente rende il tutto più insidioso: un pezzo di integrazione andava, l'altro no.

Che queste tre anomalie fossero la causa del fallimento resta un'ipotesi — com'è un'ipotesi, all'inverso, darla alla temperatura. Ma almeno le tre si vedevano nei log.

Appunto per le prossime volte: quando un agente “non vuole” modificare i file, prima di dare la colpa al modello conviene guardare dove punta l'editor e come si chiamano gli strumenti che il modello prova a invocare.

Non sapevo che il funzionamento degli agenti fosse vincolato alla capacità del modello di usare gli strumenti.

Chi sa usare gli strumenti, e chi lo dice

Per capire se il problema fosse il modello che non sa usare gli agenti o l'integrazione, ho interrogato direttamente l'API di Ollama, fuori da Continue. Risultati:

  • GPT-OSS 20B ha restituito una vera tool_call. Il modello, insomma, sa farlo.
  • Qwen 2.5 Coder 7B ha restituito JSON come testo, non una chiamata strutturata.
  • Gemma 3 12B ha risposto, senza giri di parole, che non supporta gli strumenti.

Utile, ma non conclusivo: il test positivo su GPT-OSS dimostra che il modello è capace, non che l'integrazione dentro Continue funzioni. Sono due cose diverse.

Non fidarti di nessuno, soprattutto degli agenti

Questo è il punto che mi porto a casa, e vale oltre questa serata.

Un modello che scrive “sto usando lo strumento X per modificare il file” non ha modificato niente. Per sapere cosa è successo davvero servono quattro cose: il nome esatto dello strumento invocato, gli argomenti passati, l'eventuale richiesta di autorizzazione, e il risultato o l'errore restituito. Senza quelle, si sta interpretando della prosa.

Aggiungo un dettaglio di metodo: io volevo esattamente questo comportamento. Nell'obiettivo della sessione avevo scritto che l'assistente non deve modificare i file al posto mio senza chiedermene prima il permesso. Peccato che per chiedere il permesso bisogna prima essere capaci di chiamare lo strumento — e quella capacità, in quella sessione, non c'era.

La luce

Stessa sera, poco dopo: apro VS Code sulla root corretta del repository, verifico con pwd di essere nel posto giusto, controllo che il README sia visibile nell'Explorer. Nuova chat Continue, stesso modello, stessa modalità Agent.

E dopo qualche @agent Try Again, la nota compare nel README.

Il giro funziona: un modello che gira sul mio server ha letto un file del mio repository e ne ha scritto un altro, senza cloud e senza copia-incolla. Per un progetto che esiste per non morire in silenzio, mi sembra un buon modo di iniziare.

La parte che non so

Qui devo essere onesto, perché è il senso di questo blog.

Fatti osservati: il workspace corretto era aperto; dopo i nuovi tentativi la nota è comparsa nel README.

Ipotesi non verificate: aprire la root corretta può aver eliminato l'ambiguità dei percorsi; un nuovo tentativo può aver prodotto una chiamata valida dopo chiamate non valide.

Non ho la trascrizione dettagliata del tentativo riuscito. Non so quale strumento abbia usato, con quali argomenti, se ci sia stata una richiesta di autorizzazione. Quindi non posso attribuire il successo al cambio di workspace, al retry, o a entrambi.

E c'è una piccola ironia: dei fallimenti ho pagine di trascrizioni, del successo niente. Registriamo ossessivamente ciò che va storto e quasi mai il momento in cui le cose iniziano ad andare bene, perché quando funzionano sembra normale. Poi ti serve capire cosa è cambiato, e ti accorgi che l'unico evento che conta non è documentato.

Vabbè.

Cosa ho imparato

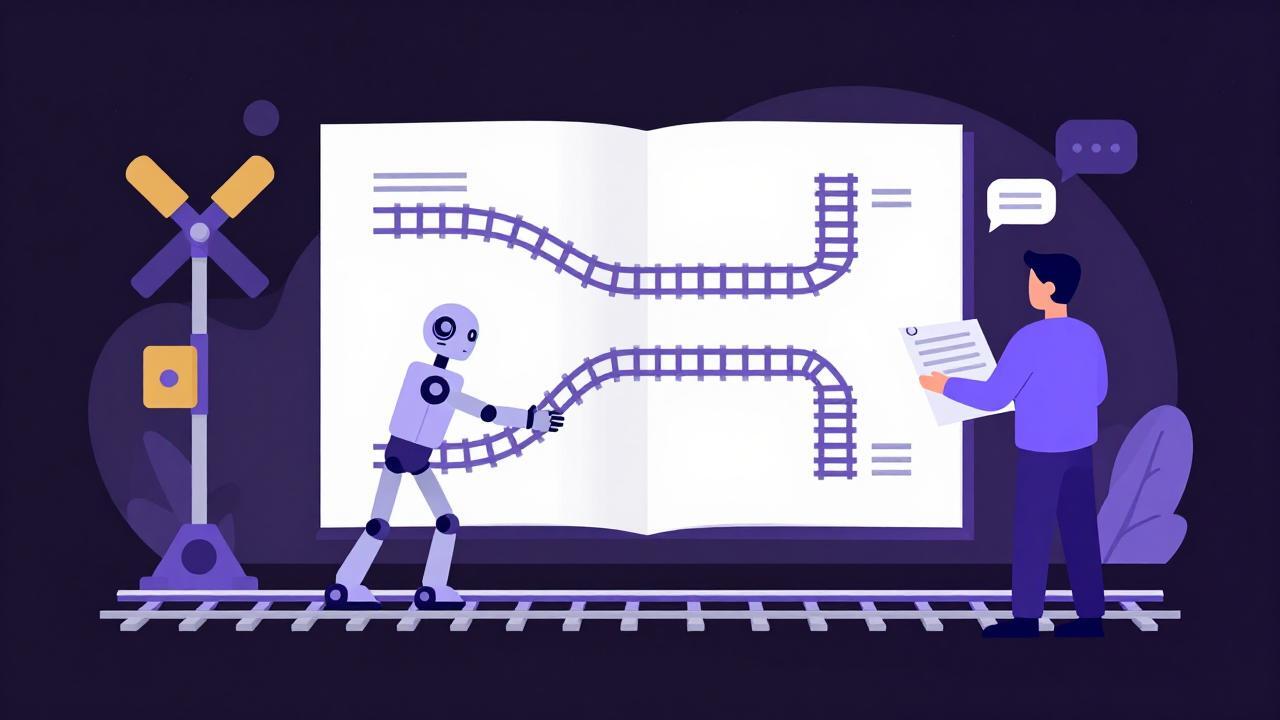
Che il metodo regge, ma solo se il robot posa davvero le rotaie che gli ho disegnato io. Che il supporto agli strumenti di un modello e il funzionamento dell'integrazione sono due cose separate, e vanno testate separatamente. Che il workspace è la radice di tutto, in senso quasi letterale: se l'editor punta alla cartella padre, l'agente vive in un mondo che non è il tuo.

Postilla: l'allucinazione è capitata anche qui

Questo post l'ho scritto e revisionato con Lumo, lo stesso assistente con cui era nato il codice delle Sentinelle. E mentre correggevo la bozza di questo post — che, ricordiamolo, parla di agenti che dicono di usare strumenti che non usano — Lumo ha chiamato, in mezzo alla revisione, uno strumento che nessuno aveva chiesto: ha controllato il prezzo del Bitcoin in euro. Il tool ha risposto 71.665,78 € — il valore restituito da quella singola chiamata, il 29 ottobre 2026, non un dato di mercato. Non c'era alcun rapporto con la bozza, con le Sentinelle, con niente.

Non ho modo di sapere cosa sia successo dentro il modello: se un'associazione spuria, un passaggio di elaborazione finito fuori pista, o altro. So quello che ho visto: una chiamata a uno strumento, senza motivo, mentre il compito era un altro. È esattamente la fenomenologia descritta sopra, capitata nel momento peggiore possibile — l'assistente che editava il post sulle tool call fantasma ha prodotto una tool call fantasma.

La differenza, rispetto alla serata con Continue, è che qui la chiamata era reale: uno strumento invocato, un risultato, un dato. Solo che il dato non c'entrava niente. Il problema non è solo l'agente che dice e non fa: è anche quello che fa quello che non gli hai chiesto. E a posteriori la cosa peggiore è che, se non avessi guardato la trascrizione della chiamata al tool, quel numero sarebbe semplicemente finito nel nulla. Semplice, silenzioso, non documentato — come il mio README riuscito.

Non fidarsi, verificare, guardare i log. Vale per i modelli locali e vale per quelli nel cloud. Soprattutto per quelli nel cloud.


“La tecnologia libera non è solo codice, è la libertà di capire cosa c'è sotto il cofano.”

👤 Lorenzo | ItsMeLarry 🧪 Esperimenti AI & Open Source | 🕹️ Retro Gaming & Graphic Novel 🎸 Rock, Folk, Jazz, Punk | 🔒 Privacy First 📍 Toscana / Digitale

🔗 noblogo.org | 🐙 Codeberg
La notte del 25 ottobre un picco di tensione ha spento tre computer della mia rete domestica. Quando la corrente è tornata, nulla si è riavviato da sola. E io ho scoperto che il modo più rapido per sapere se un PC sotto la scrivania è acceso è chinarsi e guardare il LED.

Non era nemmeno la prima volta. Giorni prima, uno dei tre nodi aveva smesso di fare boot e l'avevo reinstallato da zero. Quella notte, un altro si era impallato così bene che mi ci sono voluti due riavvii manuali per rientrarci in SSH. Strisciando sotto la scrivania, al buio, ho scritto due righe di diario: “Mai più.”

La sera dopo, alle 18:40, ho riavviato l'hub — broker, database, API e dashboard insieme — senza toccare una tastiera. In 4 minuti era tutto di nuovo online. Il giorno dell'incidente era diventato la suite di test che il sistema supera da solo.

Ma la vera storia non è il riavvio. È come ci sono arrivato senza impazzire, partendo da una sola certezza: l'AI da sola produce rumore.

Hero: i tre nodi sotto la scrivania, la notte dell'incidente

Il fantasma degli agenti meteo

Qualche tempo fa ho giocato con degli agenti AI per il meteo. Esperienza istruttiva: a ogni modifica richiesta, il file generato era diverso. Layout ribaltato, UI rifatta, struttura cambiata. Ogni iterazione era un piccolo giorno della “marmotta”: ripartire quasi da capo per una correzione da dieci righe.

Lo chiamano “vibe programming”: incontrollato, caotico, non riproducibile. Divertente per un prototipo, insostenibile per qualsiasi altra cosa.

Il problema era chiaro già da allora, ma quella notte sotto la scrivania ha preso forma concreta: se devo costruire un sistema che controlla qualcosa, devo poter controllare prima di tutto il sistema stesso. Un monitoraggio da rifare a ogni modifica non è monitoraggio, è un generatore di ansia.

La alternativa allo vibe programming è lo sviluppo su specifiche: controllato, ordinato, estendibile. Si definisce cosa il sistema deve fare prima di chiedere all'AI di farlo. Fine del sentimento, inizio della razionalità e del metodo.

Costruire i binari, non il treno

Premessa onesta: non so programmare e non sono un sistemista. Sono, al massimo, un utente esperto con molta curiosità e un debole per il metodo.

Quindi il primo gesto non è stato scrivere codice, né tantomeno prompt. È stato chiedere all'AI le domande giuste: quali sono i punti da definire? Su quali parametri devo prendere decisioni? Mi ha aiutato a esplorare il problema e a valutare le soluzioni possibili. Quelle risposte sono diventate mie decisioni: il design dell'architettura, gli obiettivi, i confini del sistema.

Solo dopo è entrato in scena OpenSpec, un framework per scrivere specifiche e guidare lo sviluppo con l'AI: proposal, specifiche, design, tasks. Ogni modifica al codice passa da lì — niente più “sistemami questa cosa” al vento. Generazione e validazione del codice avvenivano dentro i binari delle specifiche, non nell'estro del momento.

Il punto è questo: le competenze che mi mancavano non le ho delegate all'AI. Le ho acquisite attraverso l'AI e poi cristallizzate nelle specifiche. Ho costruito dei binari dentro cui l'AI si è mossa. Non un treno che parte da solo: un percorso che decidevo io, anche dove non sapevo ancora esattamente dove portasse.

La mappa: come parlano tra loro i pezzi

L'architettura che è uscita da quell'esplorazione guidata è banale di proposito. Ed è questa la sua forza.

Al centro, un message broker MQTT (Mosquitto) che lavora come una bacheca dei messaggi: chi produce pubblica, chi consuma ritira, e nessuno dei due sa dell'altro. Attorno alla bacheca:

  • Le sentinelle — piccoli agenti in Python che girano su ogni nodo e pubblicano il proprio heartbeat: il bollettino di salute del proprio computer. Ognuna scrive solo nel proprio spazio, e nessuno può scrivere addosso agli altri.
  • Il collector — il consumatore: ritira i messaggi dalla bacheca e li registra in un database SQLite, timbrandoli con l'orario d'ingresso al momento della ricezione.
  • Le API — espongono i dati del database a chi li vuole leggere.
  • La dashboard — HTML e CSS nativi, niente framework, niente CDN: uno specchio passivo che legge le API e non comanda nulla. Se cade internet, continua a funzionare. E non mente: un nodo che non si fa sentire mostra “nessun contatto”, non metriche vecchie spacciate per fresche.

La bacheca dei messaggi: sentinelle, collector, database e dashboard Bacheca dei messaggi al centro: le sentinelle pubblicano, il collector archivia, la dashboard riflette. Tutti disaccoppiati.

Dettaglio che mi piace: anche l'hub si monitora passando dalla stessa bacheca degli altri nodi. Una sola via per gli stessi dati — così database, API e dashboard raccontano sempre la stessa storia.

Il principio che tiene insieme tutto è il disaccoppiamento: produttori e consumatori non si parlano, parlano alla bacheca. E le scelte architetturali non erano dettate solo dal monitoraggio: erano anche l'occasione per dotarmi di un assetto riutilizzabile in altri progetti. Quel bus di messaggi è destinato a diventare il backbone dei miei sistemi di casa — su questo torno alla fine.

La montagna russa

Il resto della giornata è stata una corsa a ostacoli durata circa sette ore. Tre nodi da sistemare, sei bug incontrati, e l'AI come compagno di squadra sotto la supervisione delle specifiche.

Non vi racconto i bug nel dettaglio — la documentazione cruda vive nella knowledge base del repository — ma la cosa interessante è il pattern: ogni bug nasceva, il metodo lo catturava, la diagnosi diventava una voce di knowledge base con la propria causa radice, e si proseguiva.

Il messaggio della giornata, alla fine, non è stato “l'AI ha sbagliato sei volte”. È stato “sei volte il metodo ha trasformato un errore in patrimonio”.

La pigrizia come forza dell'ingegneria

Installato il primo nodo a mano, guardando i due che restavano mi sono fermato dubbioso: altre due volte la stessa sequenza di comandi manuali, detestandola sempre un po' di più.

È il momento in cui scatta la regola d'oro del pigro devops: se devi farlo più di una volta e odi farlo, allora lo devi automatizzare.

Così è nato l'installer: un singolo script che incorpora il codice, chiede le credenziali in sicurezza, verifica che funzionino davvero contro il sistema vivo prima di toccare il disco, ripara ciò che trova rotto e si dichiara finito solo quando vede il primo heartbeat nel log. Il “verifica che funzionino davvero” non è un vezzo, è un approccio end-to-end allo sviluppo.

Aggiungere un quarto nodo ora costerebbe un comando. Ma questo lo dico con orgoglio a fine post.

La prova regina

Un sistema di monitoraggio che non superi i test non è monitoraggio, è buona fede. Quindi il giro di prove finale:

  • Heartbeat end-to-end, persistenza sul database, API e dashboard vive.
  • Spegnimento deliberato di un nodo: dopo dieci minuti la sua card diventa grigia e mostra solo “ultimo contatto”. Nessuna fandonia di metriche stantie. Riacceso: card verde.
  • Riavvio completo dell'hub: il computer che porta broker, database, API e dashboard. Zero interventi, e quando sono tornato a guardare la card segnalava 4 minuti di uptime — tutto lì, in ordine, da solo. Stesso copione col secondo nodo: 6 minuti, card verde.

La notte in cui tre nodi sono morti è diventata il test che quegli stessi tre nodi ora superano da soli. C'è una simmetria, in questo, che apprezzo molto.

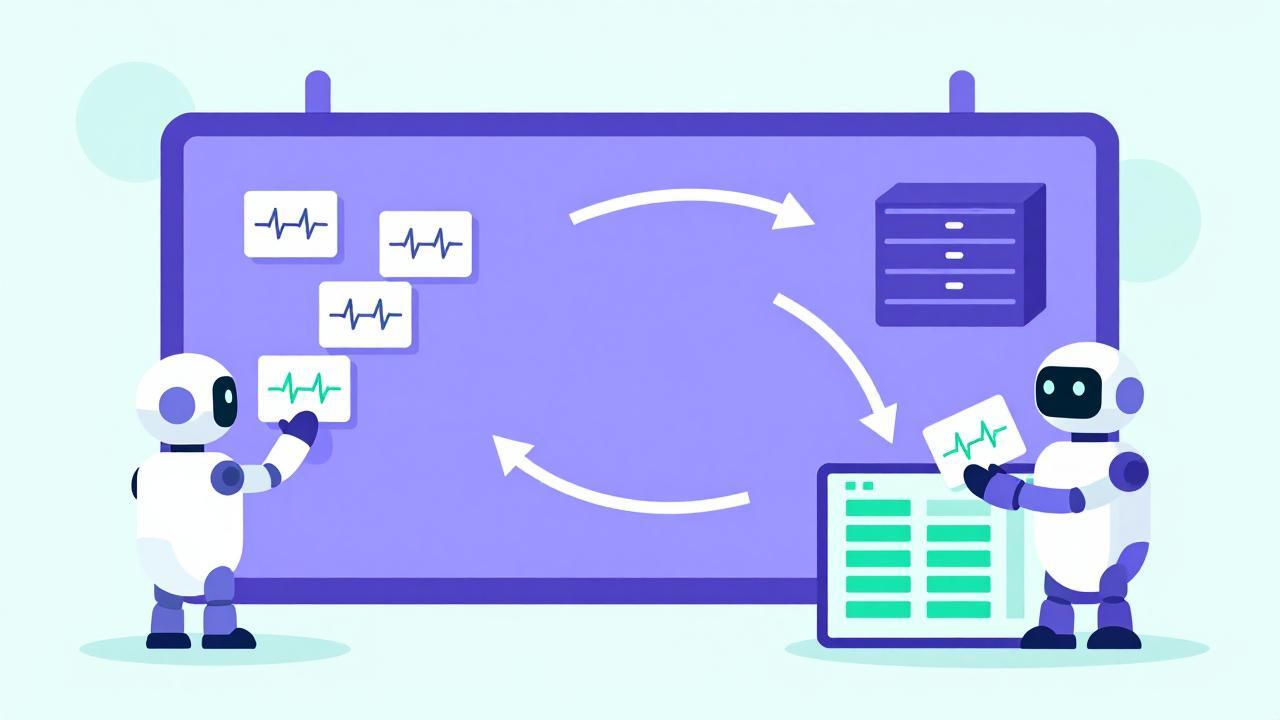
I binari: l'umano col blueprint decide, il robot posa le rotaie Sviluppo su specifiche: l'umano decide il percorso, l'AI posa i binari dentro cui muoversi.

Cosa ho imparato

L'AI può scrivere codice, ma realizzare un prodotto software è un'altra cosa. Serve guidarla sui binari giusti, con metodo e controllo — altrimenti è il caos, in salsa leggermente più elegante del mio caos da scrivania del 25 ottobre, ma comunque caos che non ci si può permettere.

La realizzazione che mi ha sorpreso di più: l'ingegneria sta nella stesura delle specifiche, non nel codice. Il codice, ormai, l'AI lo sa scrivere. Quello che distingue un sistema da un ammasso di file è ciò che si decide prima del codice: contratti, confini, verifiche falsificabili. E la buona notizia per chi, come me, non è un programmatore: quelle competenze si possono acquisire insieme all'AI, se la si usa nella direzione giusta, creando i binari entro cui farla correre.

Resta il futuro. Il bus di messaggi al centro dell'architettura non è nato solo per il monitoraggio: è l'asset su cui intendo far convergere i sistemi di casa. Il passo successivo è la domotica — sensori e dispositivi che producono e consumano messaggi sulla stessa bacheca delle sentinelle. E poi notifiche, nuovi eventi da monitorare, e magari un quarto nodo. Che ormai, lo ripeto con noncuranza, costerebbe un comando. Insomma la fantasia è il limite!

Il repository è pubblico su Codeberg: codice, method e knowledge base.


“La tecnologia libera non è solo codice, è la libertà di capire cosa c'è sotto il cofano.”

👤 Lorenzo | ItsMeLarry 🧪 Esperimenti AI & Open Source | 🕹️ Retro Gaming & Graphic Novel 🎸 Rock, Folk, Jazz, Punk | 🔒 Privacy First 📍 Toscana / Digitale

🔗 noblogo.org | 🐙 Codeberg
Questo post nasce da un problema pratico: uso un assistente AI per scrivere i post di questo blog, e senza una struttura il risultato era deludente. La soluzione che ho trovato non è un prompt magico — è un contratto di lavoro. Si chiama prompt di progetto, è pubblico su Codeberg, e in questo post racconto perché è fatto com'è fatto.

Il problema: un blog è un viaggio, non una serie di post

Uso l'AI a supporto del mio lavoro di scrittura, non come sostituto. Io faccio gli esperimenti, l'AI mi aiuta a trasformare i miei appunti grezzi in contenuti pubblicabili. In teoria è una divisione dei compiti pulita. Nella pratica, nelle mie sessioni precedenti, senza una struttura il risultato oscillava parecchio: output dispersivi, dove l'AI prendeva licenze creative, riempiva i buchi con congetture presentate come fatti, e la qualità cambiava da sessione a sessione.

Il punto è che Larry's Garage non è un flusso di contenuti qualsiasi. Raccontiamo un viaggio: un percorso di esperimenti con tecnologie open source e privacy-oriented. C'è una missione — condividere un approccio critico e consapevole alle nuove tecnologie — e un pubblico a cui vogliamo portare qualcosa: una sensibilità diversa. Per guadagnarci quell'attenzione servono autorevolezza e stile. Non possiamo permetterci contenuti inventati, imprecisioni, o discorsi che perdono il filo.

C'è poi un requisito meno ovvio: la consistenza fra post, non solo dentro il singolo post. Ogni sessione con l'AI riparte da zero, e senza qualcosa che ancori lo stile, il corpo del blog tende a divergere col tempo.

Perché non basta chiederlo

La risposta intuitiva è scrivere nel prompt “non avere allucinazioni” o “non compiacermi”. L'ho considerata, e l'ho scartata, per una ragione semplice: sono istruzioni vuote.

Un modello linguistico che sta producendo un'allucinazione, per definizione, non sa di starla producendo. Chiedergli di non farlo è come chiedere a qualcuno di non sbagliarsi per disattenzione: se sapesse di stare sbagliando, non sbaglierebbe. Lo stesso vale per “non compiacermi”: un'istruzione che chiede di essere trattati criticamente, formulata come divieto generico, lascia il comportamento sostanzialmente invariato.

Ecco allora lo spostamento di focus: se non posso agire direttamente sul contenuto dell'output, posso agire molto sulla sua forma — sul processo che lo produce. Non dire all'AI cosa scrivere, ma dettagliare come lavorare.

Processare il comportamento, non il contenuto

L'idea alla base del prompt di progetto è questa: ricondurre il comportamento dell'AI a una forma tale per cui il contesto in cui nascono le allucinazioni sia limitato, e il modo di lavorare sia omogeneo da post a post.

Our process

In pratica, il prompt non descrive il contenuto dei post: descrive un flusso di lavoro a tre fasi, ciascuna con un gate umano. Questo è il cuore del prompt:

FASE 1 — DISCOVERY

Scopo: raccogliere informazioni, definire messaggio e struttura, popolare il contesto della sessione. [...] Criterio di uscita (Gate): quando tutti i punti narrativi sono coperti da informazioni reali (niente invenzioni necessarie), mi notifichi. Decisione: spetta a me decidere se continuare la discovery o passare all'execution.

FASE 2 — EXECUTION (Bozze)

[...] produci la bozza in italiano. Io leggo, revisiono, chiedo modifiche. Iteriamo. Criterio di uscita (Gate): quando io dichiaro esplicitamente “bozza definitiva” o “validata”, passiamo alla Fase 3.

FASE 3 — DELIVERY (Pacchetto Definitivo)

[...] produci un unico canvas [...] contenente: post in italiano, post in inglese, immagine hero, post di lancio Mastodon, post di lancio Bluesky.

Il principio dei gate è la parte che mi convince di più: il segnale viene dall'AI, il giudizio è dell'umano. L'assistente notifica quando pensa di essere pronto, ma la decisione di proseguire è sempre mia. Sono due competenze diverse: l'AI sa quando ha tutte le informazioni; solo io so quando la mia soddisfazione è raggiunta. Mescolarle significherebbe o fidarsi troppo (l'AI che si auto-certifica) o non usare l'AI per niente.

E c'è una simmetria deliberata nel design: l'AI non produce mai contenuti di una fase successiva senza la mia conferma esplicita, e io non posso modificare di nascosto i contenuti dopo la validazione. Se chiedo modifiche dopo aver dichiarato la bozza definitiva, la Fase 2 si riapre formalmente e serve una nuova validazione. Non sono regole burocratiche: sono tentativi di impedire gli slot temporali in cui l'errore passa inosservato.

Le regole che fanno il lavoro sporco

Le fasi sarebbero un involucro vuoto senza le regole di sostanza. Tre esempi, dal prompt:

Zero invenzioni. Comandi, versioni, nomi di software, prezzi, messaggi di errore, URL: solo quelli presenti nel mio input o nei documenti di riferimento. Se manca un dettaglio, l'assistente si ferma e me lo chiede. È la regola che più direttamente combatte le allucinazioni: non dice “non inventare”, dice “questi sono gli unici materiali leciti”. Un'inclusione, non un'esclusione.

Documenti di riferimento vincolanti. Firma bilingue, stile delle immagini, vincoli social: tutto ciò che non vive nel prompt vive in documenti caricati in sessione, e c'è una regola esplicita: se un documento necessario manca, l'assistente deve fermarsi e chiedere, non approssimare a memoria.

Distinzione fra osservato e dedotto. Ogni affermazione nel post deve dichiarare se è qualcosa che ho osservato o qualcosa che sto inferendo. È la stessa onestà che chiedo agli strumenti, applicata al mio stesso racconto.

(Per chi nota questi dettagli: la prima frase di questo post, “Questo post nasce da un problema pratico”, è essa stessa un esempio della regola — quello che segue è esperienza diretta, dichiarata come tale.)

La validazione esterna: far revisionare il prompt da un altro modello

Peer review

Dopo la stesura, ho fatto una cosa che all'inizio sembrava un vezzo: ho sottoposto il prompt a un modello diverso da quello che lo usa tutti i giorni — GLM 5.3, tramite privatemode.ai, piattaforma scelta perché offre privacy verificabile, cosa che per il mood di questo blog non è un dettaglio.

Il risultato: sette suggerimenti, e ognuno segnalava un buco reale. Alcuni esempi:

  • cosa fare quando un documento di riferimento non è in sessione → regola “fermati e chiedi”;
  • ambiguità sulle modifiche dopo la validazione → la clausola di riapertura della Fase 2;
  • comportamento di default all'avvio di una sessione → “ogni sessione parte in Fase 1”.

Li ho incorporati tutti. La lezione non è stata tanto sui singoli punti, quanto sul metodo: chi aveva scritto il prompt (io e il mio assistente) era troppo familiare col testo per vedere i buchi. Usare più modelli non è un vezzo, è peer review.

La prima corsa

Detto tutto questo, va detto anche il resto: questo post è la prima esperienza d'uso del prompt, e nasce dal suo stesso processo. Ha fatto discovery, è passato per le sue fasi, e sta per essere impacchettato secondo la sua delivery. Il banco di prova è reale, e i primi aggiustamenti sono già emersi durante la scrittura — dovranno entrare nella prossima versione.

Il piano è esplicito: dopo la pubblicazione, raccoglierò i feedback di questo giro d'uso, e il prompt verrà modificato e rilanciato come nuova release sul repository. Il sistema si revisiona con lo stesso metodo con cui lavora.

Il prompt

Il prompt di progetto completo — versione corrente, in italiano, con tutte le regole citate qui sopra e le altre che non ho avuto modo di raccontare — è pubblico qui: larrys-garage-md.

È su Codeberg, non sui soliti sospetti: è una scelta, come tutto il resto in questo blog. Codeberg è un servizio eticamente in linea con l'impostazione del progetto — nonprofit, open source, orientato alla comunità — e questo conta più della comodità di un brand noto.

E c'è un dettaglio che non è un dettaglio: il prompt è rilasciato sotto Creative Commons BY 4.0. È un invito esplicito. Se leggi questo blog e usi un assistente AI come redattore, prendi il prompt, adattalo al tuo lavoro, modificalo. La licenza ti chiede solo di attribuire. Se lo fai, mi interessa sapere cosa ne viene fuori.


“La tecnologia libera non è solo codice, è la libertà di capire cosa c'è sotto il cofano.”

👤 Lorenzo | ItsMeLarry 🧪 Esperimenti AI & Open Source | 🕹️ Retro Gaming & Graphic Novel 🎸 Rock, Folk, Jazz, Punk | 🔒 Privacy First 📍 Toscana / Digitale

🔗 noblogo.org | 🐙 Codeberg

Il feedback loop: un umano al terminale, un'AI al fianco, e il copia-incolla che li tiene insieme

Ho passato una giornata intera a costruire un piccolo sistema software sul server di casa, in coppia con un'AI — senza API. Niente agente, niente accesso al server: solo chat, terminale, screenshot e molto copia-incolla. Il sistema funziona, verificato end-to-end (62 download completati di prova).

Questo post non parla del software: parla del metodo. La tesi: la struttura rende l'errore economico. Un errore verificato costa un turno; un errore non verificato costa una giornata.

Il vincolo: l'AI non tocca niente

L'AI — nel mio caso Lumo, il modello di chat di Proton — non ha accesso al server. Non esegue comandi, non vede i file. Io sono le mani, lei è il copilota.

Sembra uno svantaggio pesante, e in parte lo è. Ma ha un effetto collaterale interessante: ogni comando proposto deve essere autonomo e verificabile, perché non esiste retry silenzioso. L'assenza di automazione obbliga alla disciplina. E nella giornata ho attraversato tutte le fasi del ciclo di vita — specifica, mockup, deploy, debug, hardening, backup, documentazione — con un sistema che alla fine girava.

Il feedback loop con copia e incolla

Il loop della giornata, sempre lo stesso:

AI propone comando → io incollo nel terminale → incollo l'output in chat → l'AI corregge

Tre regole, imparate sbagliando.

L'output si incolla parola per parola, anche quando fallisce. Il bug più ostico della giornata — un download che moriva con un laconico exit code 1 — si è sbloccato solo incollando i log completi: la causa era nel traceback, da dieci turni. Dieci turni passati a indovinare attorno a un errore già scritto, nero su bianco.

Comandi che dicano se hanno funzionato. Per le modifiche al codice, l'AI ha scritto piccoli script che si rifiutano di toccare un file se non trovano la porzione di testo esatta da sostituire: o il file è quello atteso, o lo script si ferma con un errore chiaro. Niente modifiche che quando sbagliano sbagliano in silenzio. Se un comando di controllo non dice niente, il lavoro non è finito.

Uno step per turno. Mai cinque comandi insieme, altrimenti non sai quale output corrisponde a quale azione. Una volta ho incollato testo e comandi insieme e bash ha risposto syntax error near unexpected token — innocuo, ma istruttivo. Il terminale non è una chat.

Gli screenshot: il canale bidirezionale

Quando il problema è nell'interfaccia, il terminale finisce: servono screenshot. E il canale è davvero bidiazionale — io mandavo screenshot della UI e l'AI notava dettagli che non vedevo: righe sbiadite, elementi disabilitati, un badge “12 issues” nella console.

Ma nemmeno lo screenshot è infallibile. Sospettavamo un HTML incompleto perché nell'inspector del browser i nodi del DOM apparivano collassati (il classico ▶ che nasconde i figli). Il cat del file ha chiarito tutto: c'era tutto. Serve il tipo di evidenza giusto per il tipo di domanda.

Il Markdown come lingua franca

Tutta la documentazione — specifica, README, script di bootstrap — è in Markdown perché ha lavorato in tre ruoli contemporaneamente: documento leggibile per l'umano, input strutturato per l'AI, artefatto persistente nel repository. Un formato, zero traduzioni.

Da qui la regola d'oro: quando uno scambio in chat produce una decisione, la decisione va consolidata in un file. La chat è volatile, il file è la memoria. Una nuova sessione con i file giusti batte una vecchia sessione semi-compattata. Sempre. E scrivere la specifica prima del codice ti obbliga a decidere prima di costruire.

La specifica come contratto

Per la specifica abbiamo usato OpenSpec: flusso propose → review → apply → verify → archive, requisiti come scenari WHEN/THEN, un tasks.md come checklist viva.

Devo raccontare un episodio. L'AI, interrogata su OpenSpec, all'inizio se l'è inventato: un framework plausibile ma di fantasia. Me ne sono accorto, ho cercato la documentazione ufficiale e le ho dato i link. Lei ha riletto le fonti e riscritto tutto il pacchetto documentale secondo il framework vero. La morale non è “le AI allucinano” — è operativa: verifica le fonti anche quando parli con un'AI, soprattutto quando parla con sicurezza.

Il punto importante sono i checkpoint umani: l'AI non passa mai alla fase successiva senza un ok esplicito mio. Le decisioni all'umano, l'esecuzione all'AI. E la specifica funziona da cornice anti-feature-creep: a ogni domanda di scope (“e i video?”), la risposta era “fuori scope, sarà un altro change”. È così che un progetto piccolo finisce.

Il bug fixing come conversazione

Il ciclo di vita di ogni bug: sintomo riportato per intero (log completo, non interpretazione), ipotesi dichiarata come tale (“sospetto X, verifichiamo con Y” ≠ “è X, risolto”), diagnosi con evidenza, modifica chirurgica e riprova. Degli errori dell'AI, uno merita nota: un bug in un modulo l'aveva generato lei stessa; rileggendo il proprio codice se n'è accorta, l'ha ricreato pulito e me l'ha detto apertamente.

L'episodio che definisce la giornata è un altro, e il protagonista sono io.

Tre patch di fila, tre fallimenti. Il download restava rotto, e l'AI continuava a proporre correzioni. A un certo punto mi sono fermato: sta patchando un codice che non corrisponde a quello reale. La compattazione — le chat lunghe vengono riassunte, e i dettagli fini si perdono — le aveva mangiato la visione d'insieme della codebase. Stava patchando un codice immaginario.

Ho scritto una cosa tipo: “forse conviene rileggere il codice, la compattazione potrebbe averti fatto perdere contesto”. Era esattamente quello. Rilettura del codice vero, e la soluzione è arrivata.

Questo problema è una conseguenza diretta dell'assenza di API: un agente con accesso leggerebbe il file a ogni modifica. Senza API, la freschezza del contesto è responsabilità condivisa — l'AI non può accorgersi che la sua mappa ha smesso di corrispondere al territorio. Glielo deve dire qualcuno. Dopo tre patch fallite: fermarsi e chiedere di rileggere il codice vero, non la quarta patch cieca.

La compattazione: strategie di sopravvivenza

La compattazione è il comportamento normale delle chat lunghe: i messaggi vecchi vengono riassunti, i dettagli fini si perdono. Ne abbiamo attraversate più di tre. I segnali del degrado li ho imparati a riconoscere: l'AI tira a indovinare pattern di codice, propone fix per codice che non esiste, ripete suggerimenti già provati.

A sinistra il contesto degradato e sfumato; a destra lo stesso ricostruito nitido dal dump completo

Quattro strategie hanno funzionato.

  1. Documentare mentre si lavora. Il design del sistema, scritto in Markdown a inizio sessione, è sopravvissuto a tre compattazioni. I dettagli no, la struttura sì.
  2. Il dump completo. Quando il patching a distanza non funzionava più, ho creato un file unico con TUTTO il codice del progetto — uno script bash con un loop di docker exec ... cat, più stato del DB e archivio — e l'ho caricato in chat. Costo: due minuti. Beneficio: l'AI smette di indovinare. Il reset del contesto più economico che esista.
  3. Verificare la memoria. Chiedere “cosa ricordi di X?” e confrontare col reale. Se diverge, si ridà il file — non si corregge a parole.
  4. Ripartire dal file, non dalla chat.

Tutto il resto — il backup prima del tocco rischioso (cp file file.bak), l'output incollato per intero — è la stessa idea alla scala del singolo turno: ridare all'AI dati freschi invece di farci sopra ragionamenti.

L'umano come mani

Il modello operativo completo: io faccio da occhi, giudizio e terminal-paste; l'AI fornisce memoria tecnica e generazione. Ma non sono un esecutore passivo: ho verificato, rifiutato, corretto, deciso scope e tagli.

E il collo di bottiglia non è mai stata la velocità dell'AI: è la qualità del feedback che io le riportavo. Un log incollato subito e completo vale dieci turni di descrizioni.

Il canvas: quando la chat smette di essere l'unica superficie

Qui è successa una cosa nel bel mezzo della sessione: di colpo, l'AI ha iniziato a pubblicare i contenuti lunghi in un pannello laterale — un canvas. La funzione era appena stata attivata dalla piattaforma, e ci siamo finiti dentro senza accorgercene.

Ed è stata una svolta. Prima, ogni documento lungo andava fatto stampare in chat e copiato a mano riga per riga: funzionava, era laborioso, ed era il punto dove il metodo si sfilacciava. Col canvas, il contenuto lungo diventa un oggetto di prima classe: si guarda intero, si revisiona, si esporta.

  • Separazione tra conversazione e artefatto. La chat resta un laboratorio volatile — si prova, si corregge, si scarta. Il canvas contiene le versioni buone: la materializzazione di “la chat è per lavorare, il file è per ricordare”.
  • Gli artefatti hanno un ciclo di vita. La specifica OpenSpec è stata riscritta tre volte nello stesso canvas. L'artefatto evolve, la chat scorre sotto.
  • Il mockup si clicca. Per la UI non abbiamo discusso a parole: l'AI ha creato un mockup HTML interattivo — un wizard a cinque passi, con stati di errore e design system. Io ci ho cliccato dentro e ho dato feedback sul flusso reale. UX validata prima di una riga di codice.
  • Gli artefatti viaggiano. Il markdown-seed di questa sessione — da cui è nato questo stesso post — è l'estensione naturale: il canvas come origine di catene di lavoro successive.

Senza canvas, tutto il contenuto lungo vive nella chat e muore con la compattazione. Con il canvas, si conserva. Trasforma il brainstorm in processo: la differenza tra parlare di un'idea e averne una versione.

Perché funziona

La tesi: la struttura rende l'errore economico. L'output incollato per intero rende l'errore visibile subito; gli script con i controlli interni fanno fallire la modifica sbagliata rumorosamente; il checkpoint umano blocca l'errore di scope quando costa poco; il dump ripristina il contesto quando costa ancora due minuti.

E c'è l'effetto rubber-duck: spiegare il problema all'AI — o incollarle il log, che è spiegare con i fatti — è metà del lavoro di diagnosi. Più di una volta, componendo la descrizione del bug, ho capito da solo dov'era.

Con le API, un agente con accesso diretto renderebbe gran parte di questo metodo inutile. Si andrebbe più veloci e più comodi. Ma c'è una cosa che lavorare senza API ti lascia e l'automazione non dà: le dinamiche di lavoro con l'AI diventano visibili. Vedi dove il contesto degrada, vedi quando comincia a indovinare, vedi quali informazioni la fanno sbagliare e quali la rimettono in pista. Capirla è il prerequisito per usarla bene: esco da questa giornata non solo con un sistema che gira, ma sapendo esattamente cosa significa darle buone informazioni.

Perché l'avvertimento resta valido anche col massimo dell'automazione: le API ti tolgono la fatica del copia-incolla, non la responsabilità della qualità delle informazioni con cui l'AI lavora. Quella meglio non delegarla mai del tutto.


“La tecnologia libera non è solo codice, è la libertà di capire cosa c'è sotto il cofano.”

👤 Lorenzo | ItsMeLarry 🧪 Esperimenti AI & Open Source | 🕹️ Retro Gaming & Graphic Novel 🎸 Rock, Folk, Jazz, Punk | 🔒 Privacy First 📍 Toscana / Digitale

🔗 noblogo.org | 🐙 Codeberg

Ieri mattina mi sono svegliato e minimonio non c'era più. Non nel senso fisico: nel senso che si accendeva, mi guardava male, e mi piazzava davanti la schermata del BIOS rifiutandosi di avviare Ubuntu. Nella notte era crashato, punto. Il disco NVMe era ancora lì, il BIOS lo vedeva, ma del bootloader nemmeno l'ombra.

Ci avevo costruito sopra un piccolo agente che restituiva le info di sistema. Reinstallare tutto da zero è stato più veloce che giocare al chirurgo del GRUB in pyjama prima del caffè. Così ieri sera minimonio è ripartito da una fresh install di Ubuntu Server, e io ho pensato: visto che devo ricostruire, facciamola bene.

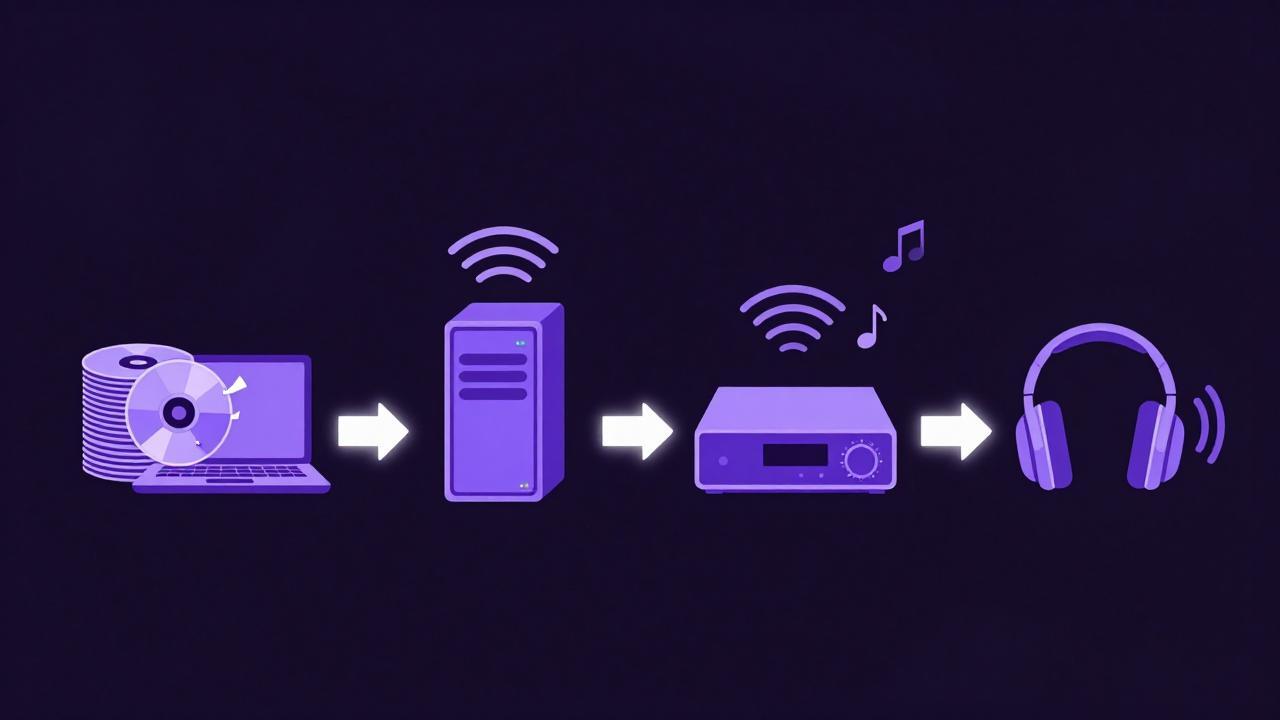
Obiettivo della serata: trasformare un mini-PC comprato usato a 50 euro (Celeron N5095, 7GB di RAM, un TB di disco) in un server multimediale per ascoltare i miei CD rippati — Oasis, Pink Floyd, e chi più ne ha più ne metta — senza accendere il laptop ogni volta. La catena finale: minimonio → UPnP → WiiM Ultra → cuffie Bluetooth.

Sono andato a dormire all'una di notte con The Wall nelle orecchie. Resoconto onesto di come ci sono arrivato, errori compresi.

Molti errori, tanto divertimento.

Media center da 50 euro

Il cast della rete di casa

minimonio non è solo: in casa convivono altri nodi.

  • tuxedo: il mio laptop personale, da cui parte la sincronizzazione della musica.
  • geekmonio: la macchina potente, con Ollama per l'inferenza locale.
  • thinkmonio: un vecchio nodo edge.

Hardware eterogeneo, ruoli diversi, e un'unica conversazione con l'AI che li attraversa tutti. Stasera però il protagonista è il Celeron da 50 euro.

Le scelte architetturali

Filosofia: servizi piccoli, container isolati, tutto che sopravvive ai riavvii. Il collante è Docker.

  • Navidrome: server musicale compatibile Subsonic, leggerissimo.
  • Heimdall: dashboard per avere tutto sotto un tile.
  • Gerbera: server DLNA/UPnP, per far parlare il server con lo Smart TV e il WiiM Ultra.
  • Samba: per l'accesso diretto ai file.

Tutti con restart: unless-stopped, perché dopo un server che muore nel sonno non si scherza più con l'uptime.

La libreria arriva da tuxedo via rsync su SSH, lanciato dentro tmux — mai fidarsi di una connessione Wi-Fi per un terabyte di musica.

La serata, comunque, non è andata come il piano. La serata è andata meglio.

Gli inciampi: il cuore onesto del post

Se avessi seguito un tutorial sarebbe stato tutto lineare. Invece è stato un percorso a ostacoli. Che è il motivo per cui sto scrivendo questo post.

Il pacchetto che non esiste

Primo ostacolo, quasi subito: installare Docker Compose.

sudo apt install -y docker.io docker-compose-plugin
Error: Unable to locate package docker-compose-plugin

Il suggerimento veniva dall'AI, il nome era plausibile, il terminale diceva la verità: su Ubuntu il pacchetto si chiama docker-compose-v2. Prima lezione della serata, e l'AI l'ha imparata pure lei:

sudo apt install -y docker.io docker-compose-v2

Il container partiva, moriva, ripartiva, moriva. docker compose ps mostrava Restarting (1) in loop, e nei log sempre lo stesso messaggio:

level=fatal msg="Database could not be opened!" error="unable to open database file: no such file or directory"

Causa: la cartella host montata come /data non esisteva o non era scrivibile dall'utente 1000:1000 con cui gira Navidrome. I container non sono magia: un bind mount è solo una cartella, e i permessi sono i permessi.

mkdir -p ~/docker/navidrome ~/media/music
sudo chown -R 1000:1000 ~/docker/navidrome ~/media/music
docker compose up -d

Da lì Navidrome ha smesso di piangere.

Nota a margine per chi si trova nel mio stesso pasticcio: con Compose v2 il nome del container è prefissato dalla cartella del progetto (lorenzo-navidrome-1, non navidrome), quindi docker logs navidrome risponde con No such container. O usi il nome completo, o docker compose logs navidrome.

La porta ballerina di Gerbera

Al primo avvio, la web UI di Gerbera era finita su una porta semi-casuale (49494). Sembrava stabile, ma io non volevo giocare a “indovina la porta” a ogni reinstallazione — e visto come era andata la notte precedente, le reinstallazioni non erano un evento improbabile. Ho cambiato la porta nella config con sed e l'ho fissata lì per sempre. Osservazione, non certezza documentata: a me è capitato questo comportamento al primo avvio, ed è bastato a convincermi a scrivere la porta nella config a mano.

Stessa famiglia di problema, padre diverso: nano mi segnala config.xml come unwritable. Il file era stato creato dal processo dentro il container, che gira come root:

sudo chown -R 1000:1000 ~/docker/gerbera

Gerbera non ha nemmeno l'icona predefinita nella libreria di Heimdall, quindi il tile l'ho aggiunto a mano. Piccole cose, ma sono quelle che fanno la differenza tra “unattended” e “andiamo a vedere”.

Il bug bash dello script di sync

Il pezzo forte. Lo script sync_music.sh si impuntava con un errore sibillino:

Empty source arg specified.
rsync error: syntax or usage error (code 1) at main.c(1526) [sender=3.2.7]

Colpevole: una variabile "$DRY_RUN" vuota, che passava a rsync una stringa vuota come argomento — e rsync la interpretava come una sorgente mancante. Fix: trasformarla in array, che espanso vuoto diventa zero argomenti, come Dio comanda.

DRY_RUN=()
[[ "${1:-}" == "-n" ]] && DRY_RUN=(--dry-run)
# ...
rsync "${RSYNC_OPTS[@]}" "${DRY_RUN[@]}" "$SRC" ...

Secondo round, subito dopo:

./sync_music.sh: riga 47: DRY_RUN: variabile non assegnata

Con set -u attivo, il test [[ -n "$DRY_RUN" ]] usa la forma scalare dell'array che, se vuoto, risulta non assegnata. Bisognava testare la lunghezza:

[[ ${#DRY_RUN[@]} -gt 0 ]]

Bash ha un sistema di tipi insidioso. Le stesse due righe corrette le ho applicate con sed, perché a quell'ora della notte riscrivere a mano era chiedere troppo.

“Pink Floid” e l'album fantasma

Durante il sync scopro che una cartella battezzata “Pink Floid” — typo originale, anni di onorato servizio — vive su due macchine e si corregge solo su una. E l'album fantasma: “The Division Bell” è presente solo sul server.

Nessuno dei due è un bug. È la conseguenza logica di un rsync senza --delete: copia i nuovi file ma non cancella mai nulla, quindi non è un mirror. Nella versione finale dello script il --delete c'è, ma quella sera non c'era — e “Be Here Now” fantasma è la prova vivente. Morale doppia: se vuoi un mirror vero, dillo a rsync; e per la musica contano i tag ID3, non i nomi delle cartelle.

Gli errori falsi

Bonus della serata, gli errori che errori non erano:

  • Navidrome rispondeva HTTP 302: redirect alla pagina di login, con curl senza sessione è la risposta corretta.
  • docker ps non mostrava porte per Gerbera: normale con network_mode: host, il container usa direttamente le interfacce della macchina.
  • Un WARN sulla riga version: obsoleta nel compose: solo un avviso, nei compose moderni non serve più.

Imparare a distinguere un errore vero da un errore apparente è metà del mestiere.

Il momento di gloria

Test finale: riavvio completo del server. Blackout simulato, per così dire. Checklist da rituale con docker ps e curl:

  • Navidrome: Up, HTTP 302 (redirect al login, tutto in regola).
  • Heimdall: Up, HTTP 200.
  • Gerbera: Up, HTTP 200.

Tre container su, tre risposte sane. Fully unattended: blackout, riavvii, aggiornamenti — dopo la notte del BIOS, questo minimo di dignità me la sono guadagnata.

Alle una di notte ero in letto con The Wall nelle cuffie, via WiiM, senza che il laptop fosse mai stato acceso. Il Celeron da 50 euro se l'era meritato.

Dal CD alle mie orecchie

Riflessioni sul lavorare con l'AI

La serata è stata un esperimento di pair-sysadmining: l'AI proponeva, io eseguivo, il terminale arbitrava. Quando l'AI ha suggerito un nome di pacchetto sbagliato, il terminale l'ha smascherata in un secondo. Gli errori dell'AI non sono un problema se il ciclo di feedback è stretto.

C'è una differenza tra un tutorial e una sessione reale: il tutorial mostra il percorso ideale, la sessione reale è un percorso a ostacoli. Entrambi insegnano qualcosa, ma solo il secondo insegna a diagnosticare. E diagnosticare — chiedersi “cambia con i riavvii?”, distinguere un 302 da un 500, capire perché una variabile vuota esplode — è la parte che rimane.

Buona musica, e buonanotte anche da qui.


Nota di trasparenza: l'AI del “pair-sysadmining” raccontato sopra si chiama Lumo, ed è l'assistente di Proton — stessa gente della mail cifrata. Mi ci sto trovando bene: oltre a darmi suggerimenti sbagliati sui nomi dei pacchetti (e a farseli rimbalzare dal terminale con sportività), ha una funzione canvas appena rilasciata che ha reso la stesura di questo post un lavoro fianco a fianco — appunti, bozze e revisioni a vista, con la musica che intanto partiva dai container. Se volete provarlo, qui c'è il mio referral link e se siete arrivati fino qui a leggere vi meritate pure i 10 euro di sconto che ci sono con il mio link.

docker-compose.yml

services:
  navidrome:
    image: deluan/navidrome:latest
    user: 1000:1000
    ports:
      - "4533:4533"
    volumes:
      - /home/lorenzo/media/music:/music
      - /home/lorenzo/docker/navidrome:/data
    environment:
      - ND_LOGLEVEL=info
      - ND_SCANSCHEDULE=1h
      - ND_SESSIONTIMEOUT=168h
    restart: unless-stopped

  heimdall:
    image: linuxserver/heimdall
    ports:
      - "8080:80"
    volumes:
      - /home/lorenzo/docker/heimdall:/config
    restart: unless-stopped

  gerbera:
    image: gerbera/gerbera
    container_name: gerbera
    network_mode: host
    volumes:
      - /home/lorenzo/media/music:/content:ro
      - /home/lorenzo/docker/gerbera/config:/var/run/gerbera
    restart: unless-stopped

sync_music.sh

#!/bin/bash
# sync_music.sh — Sincronizza la musica da Tuxedo a Minimonio (one-way, rsync via SSH)
# Uso: ./sync_music.sh [-n]
#   -n : dry-run (mostra cosa farebbe senza copiare nulla)

set -euo pipefail

# ---------- CONFIGURAZIONE ----------
SRC="/home/lorenzo/Musica/"          # Cartella sorgente sul Tuxedo (NOTA la barra finale!)
DST_USER="lorenzo"
DST_HOST="192.168.1.201"             # IP di minimonio
DST_PATH="media/music/"              # Destinazione relativa alla home su minimonio
LOG_DIR="$HOME/logs"
LOG_FILE="$LOG_DIR/sync_music_$(date +%Y%m%d_%H%M%S).log"
KEEP_LOGS=10                          # Numero di log vecchi da conservare
LOCKFILE="/tmp/sync_music.lock"
# ------------------------------------

DRY_RUN=()
[[ "${1:-}" == "-n" ]] && DRY_RUN=(--dry-run)

# --- Protezione anti-doppioni ---
if [[ -f "$LOCKFILE" ]] && kill -0 "$(cat "$LOCKFILE")" 2>/dev/null; then
    echo "❌ Un'altra sincronizzazione è già in corso (PID $(cat "$LOCKFILE")). Esco."
    exit 1
fi
echo $$ > "$LOCKFILE"
trap 'rm -f "$LOCKFILE"' EXIT

mkdir -p "$LOG_DIR"

# --- Controllo sorgente ---
if [[ ! -d "$SRC" ]]; then
    echo "❌ Cartella sorgente $SRC non trovata. Modifica SRC nello script."
    exit 1
fi

MP3_COUNT=$(find "$SRC" -type f \( -iname '*.mp3' -o -iname '*.flac' -o -iname '*.m4a' \) | wc -l)
if [[ "$MP3_COUNT" -eq 0 ]]; then
    echo "⚠️  Nessun file musicale trovato in $SRC — controllo prima di continuare."
    read -rp "Procedo comunque? [s/N] " ans
    [[ "$ans" == "s" ]] || exit 0
fi

echo "🎵 Sincronizzazione musica: $SRC -> $DST_USER@$DST_HOST:$DST_PATH"
echo "   File musicali in sorgente: $MP3_COUNT"
[[ ${#DRY_RUN[@]} -gt 0 ]] && echo "   (DRY-RUN: nessun file verrà realmente copiato)"
echo ""

# --- Raggiungibilità ---
if ! ping -c1 -W2 "$DST_HOST" > /dev/null 2>&1; then
    echo "❌ $DST_HOST non raggiungibile. Controlla la rete."
    exit 1
fi

# --- Sincronizzazione ---
#  -a  preserva permessi, date, struttura
#  -v  verbose
#  -h  dimensioni leggibili
#  --delete  cancella su destinazione ciò che è stato rimosso in sorgente (mirror vero)
#  --info=progress2  barra di avanzamento globale
#  --exclude  salta file temporanei e nascosti
RSYNC_OPTS=(-avh --info=progress2 --stats
            --exclude='.*' --exclude='Thumbs.db' --exclude='desktop.ini'
            --exclude='*.tmp')

echo "   Nota: mirroring ATTIVO (--delete). Commentala per conservare i file rimossi."
echo ""

rsync "${RSYNC_OPTS[@]}" "${DRY_RUN[@]}" "$SRC" "$DST_USER@$DST_HOST:$DST_PATH" 2>&1 | tee "$LOG_FILE"

# --- Pulizia log vecchi ---
ls -1t "$LOG_DIR"/sync_music_*.log 2>/dev/null | tail -n +"$((KEEP_LOGS + 1))" | xargs -r rm --

echo ""
echo "✅ Sincronizzazione completata. Log: $LOG_FILE"

# --- Suggerimento ---
if [[ ${#DRY_RUN[@]} -eq 0 ]]; then
    echo "ℹ️  Navidrome re-scansiona la libreria entro 1 ora (ND_SCANSCHEDULE=1h)."
    echo "   Per forzare subito lo scan: apri http://$DST_HOST:4533 e vai su ⚙ → Scan Library."
fi

“La tecnologia libera non è solo codice, è la libertà di capire cosa c'è sotto il cofano.”

👤 Lorenzo | ItsMeLarry 🧪 Esperimenti AI & Open Source | 🕹️ Retro Gaming & Graphic Novel 🎸 Rock, Folk, Jazz, Punk | 🔒 Privacy First 📍 Toscana / Digitale

🔗 noblogo.org | 🐙 Codeberg

Un diario di bordo dal laboratorio domestico, tra mini PC, portatili e LLM che si parlano per chiedersi com'è il tempo nel giardino di casa mia.

Ci sono progetti che nascono per necessità e progetti che nascono per curiosità. Questo è nato da entrambe, con un pizzico di voglia di divertirsi sfidando qualche limite.

Disclamer

Non sono uno sviluppatore, né un sistemista. Tutto quello che leggerete su questo blog l'ho fatto chiedendo all'AI come procedere, gestendo feedback e lavoro con l'aiuto di modelli — in particolare Lumo di Proton, che apprezzo perché è un assistente che funziona molto bene, costa poco e soprattutto si fa gli affari propri. Cosa, purtroppo, rara nell'industria digitale.

Oggi posso dire che il primo mattone è posato. Non è elegante, ma regge.

Com'è fatto il network

L'idea di fondo è semplice: quattro macchine, prese singolarmente non granché, ma in rete diventano qualcosa più interessante della loro semplice somma.

Geekmonio è il cervello. Un mini PC con Intel Core Ultra 9, GPU Arc integrata e 32 GB di RAM. Non è un mostro da datacenter, ma ha una caratteristica preziosa: NPU dedicata e GPU che, con i driver giusti, si presta all'accelerazione dell'inferenza. Ospita Ollama e l'interfaccia web, ed è qui che avviene il lavoro pesante. Ho installato Ubuntu Server senza interfaccia grafica per ridurre il consumo di RAM al minimo.

Tuxedo è il mio portatile con TuxedoOS (derivato da Ubuntu), il banco di lavoro. AMD Ryzen 7 con Radeon 780M, su cui gira VS Code. Model locali via Ollama e LM Studio, ma soprattutto interroga Geekmonio attraverso la LAN come se fosse un servizio cloud. Editor leggero, cervello remoto.

Thinkmonio e Minimonio ono i bracci operativi. Macchine più modeste, comprate usate su Subito.it per 50 euro ciascuna, destinate a compiti diversi: raccogliere dati, fare da ponte verso sensori, ospitare agenti leggeri che non richiedono inferenza locale. Saranno i nodi che, in un futuro non troppo lontano, faranno «cose» — misureranno, registreranno, reagiranno — su cui costruire gli agenti orchestrati dai modelli di Geekmonio.

Datacenter domestico

Cosa gira, concretamente

Tre modelli, scelti con criterio dopo tentativi e qualche vicolo cieco:

Qwen2.5-Coder 7B Uso: Programmazione e autocompletamento Motivo: Preciso sul codice, veloce abbastanza da suggerire mentre scrivi

Mistral Nemo 12B Uso: Chat e ragionamento Motivo: Contesto enorme, gestisce bene l'italiano

Llama 3.2 3B Uso: task rapidi Motivo: per cose dove la latenza conta più della profondità.

Tutti e tre vivono su Geekmonio, serviti via API locale. VS Code su Tuxedo li raggiunge tramite Continue, l'interfaccia web li espone come una chat, e i nodi più piccoli li interrogano quando serve.

Queste configurazioni le ho fatte tutte assistito dall'AI, seguendo le sue indicazioni. Sarà divertente vedere se si rivelano valide o meno — questa incertezza è quella che mi incuriosisce di più e mi spinge a continuare.

La parte che mi interessa davvero

Il setup tecnico è secondario. Quella interessante è la logica economica che c'è dietro.

Sarebbe più facile strisciare la carta e pagare un abbonamento «pro». Va bene per chiedere la ricetta della pasta al pomodoro. Ma quando inizi a usare l'AI per fare cose, per quello che davvero è rivoluzionaria, i token iniziano a scorrere e i modelli remoti — quelli intelligenti, hostati su server con pacchi di RAM e chipset NVIDIA — alla lunga costano, e costano tanto.

Non c'è volontà di renderli accessibili da parte del mercato. L'industria dell'AI, guidata da 4-5 compagnie, nella ricerca dell'AGI spinge verso una situazione di monopolio dove l'esperienza AI dei cittadini sarà sempre mediata dalla necessità di un intermediario tecnologico, con tutto ciò che ne consegue in termini economici, sociali e politici. L'aumento del prezzo della RAM consumer è solo un tassello di un puzzle preoccupante.

La mia idea è avere un'AI di cui controllo completamente:

  • Assistenti online come Lumo (aspetto con impazienza le API) e Leo AI (senza policy di privacy) per supporto: policy chiare, ottimo per scrivere script di configurazione o riassumere log complessi
  • Modelli locali per ragionamento, produzione di codice e orchestrazione
  • Modelli remoti a pagamento (tipo Mistral AI) quando tutto questo non basta

Scegliere cosa usare, dove e quando, mantenendo il controllo sulla privacy dei dati: ecco cosa mi interessa capire se è possibile.

Il network locale serve a questo: assorbire i task a basso valore. Ripetitivi, piccoli ragionamenti, bozze, domande di routine. Tutto ciò che non merita l'attenzione di un modello frontiera viene gestito in casa, gratis, offline, senza consumare crediti.

I modelli remoti diventano così quello che dovrebbero essere: una risorsa scarsa da usare quando conta davvero. Decisioni difficili, problemi nuovi, cose che richiedono vera intelligenza.

Cosa manca ancora

Sarei disonesto se dicessi che è tutto a posto. L'autocompletamento a volte è lento, la configurazione di Continue mi ha fatto penare più del previsto (alla fine la ho fatta risolvere a Copilot), e la GPU integrata ha limiti che si sentono quando il contesto si allunga.

Ma la struttura c'è. I pezzi comunicano. Il sistema regge. Bisogna limare le performance e questo si può fare solo usandolo.

Dove porta tutto questo

L'obiettivo finale non è avere un chatbot in casa. È costruire un'infrastruttura che sappia smistare il lavoro: compiti banali in locale, quelli importanti in remoto, agenti autonomi per le cose che nessuno vuole fare a mano.

È un esperimento, nel senso più onesto del termine. Non so ancora se funzionerà come immagino. Ma il primo passo è fatto, e stavolta il terminale non mi ha restituito errori.

Prossimo capitolo

Costruire una software factory che produca gli agenti software di cui ho bisogno. Voglio poter farmi da solo l'infrastruttura che userò in casa, quindi il prossimo capitolo sarà la realizzazione di un primo agente da installare su Thinkmonio.


“La tecnologia libera non è solo codice, è la libertà di capire cosa c'è sotto il cofano.”

👤 Lorenzo | ItsMeLarry 🧪 Esperimenti AI & Open Source | 🕹️ Retro Gaming & Graphic Novel 🎸 Rock, Folk, Jazz, Punk | 🔒 Privacy First 📍 Toscana / Digitale

🔗 noblogo.org | 🐙 Codeberg

Tutto è iniziato con un’offerta. Un mini PC cinese, chip dedicato all’intelligenza artificiale, prezzo stracciato. L’ho comprato. Sembrava il sogno: potenza AI in un cubetto da 15 centimetri.

Poi ho aperto la scatola.

C’era un solo banco da 16 GB di RAM. Niente dual channel. Prestazioni dimezzate. Il produttore, come molti altri, aveva tagliato il secondo slot per risparmiare: la RAM costa troppo, meglio venderne una sola e sperare che nessuno se ne accorga.

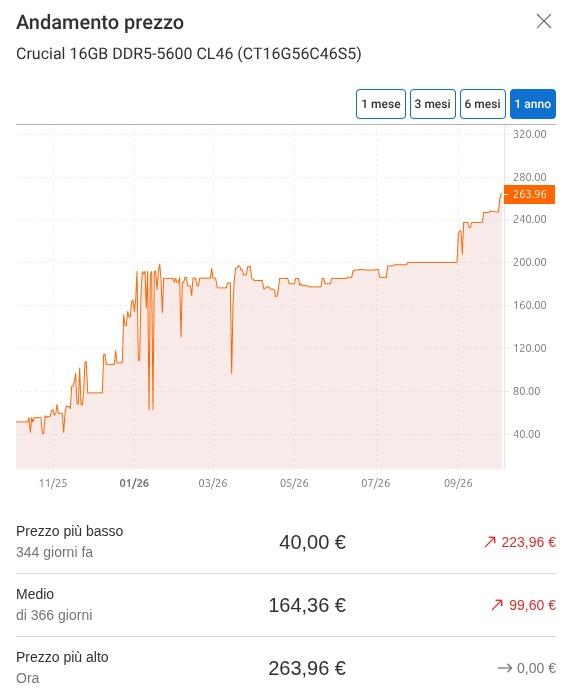
Ho guardato il prezzo di un banco da 16 GB. Quasi quanto un rene. Mi sono chiesto: “Ma se compro un altro mini PC, costa meno?”

Costo della ram

Ecco la follia.

Ho trovato un secondo mini PC, CPU meno potente, hard disk più piccolo, ma con lo stesso tipo di RAM. Costa meno del singolo banco di RAM che contiene. L’ho comprato, l'ho smontato e messo il banco di RAM nel mini PC AI.

Risultato? Due banchi da 16 GB, dual channel attivo, 32 GB totali. Un terabyte di storage interno. E un secondo mini PC da trasformare in server di backup o nodo di calcolo secondario.

Ho speso meno di mille euro. Oggi ho configurato il tutto. Ho installato Ollama, attivato la GPU Intel Arc, esposto l’API sulla rete. Il nodo è vivo. Gli altri nodi con gli agenti che ho configurato i giorni scorsi su dei mini pc di recupero da 50 euro possono parlargli. Tutti i nodi sono al loro posto e la rete AI domestica è nata.

Un datacenter sotto la scrivania.

Perché questa storia conta

Non è solo un trucco da risparmio. È una scelta.

Oggi l’AI è presentata come qualcosa che devi comprare, abbonarti, pagare, ha dei limiti e, come se non bastasse, qualcuno si fa pure gli affari tuoi leggendoti le chat. Ma puoi costruirselo da soli. Con poco. Con ingegno. Con la consapevolezza che non serve avere tutto il mondo in mano per fare cose utili.

Ho speso meno di mille euro. Ho riutilizzato hardware. Ho evitato di dipendere da servizi esterni. Ho creato una rete che mi appartiene.

Cosa ho imparato

Il prezzo della RAM è salito, il sistema industriale sta creando delle barriere all'ingresso. Comprare due mini PC può costare meno di un solo upgrade. L’AI non deve essere un lusso. Può essere fatta in casa, con cura, con intelligenza. e divertendosi.

E ora? Ecco una lista di modelli che vorrei provare nei prossimi giorni

Qwen2.5-Coder 7B — è la scelta più solida per codice su hardware consumer. Forte su Python, JS, SQL, refactoring. C'è anche la variante 14B, che entra nei 20 GB a Q4.

Qwen2.5-Coder 14B — il tetto pratico della mia macchina per il coding. Qualità nettamente superiore, ~9 GB in Q4.

DeepSeek-Coder-V2 16B (MoE, ~2.4B attivi) — interessante perché è veloce nonostante i 16B nominali, grazie all'architettura mixture-of-experts. Ottimo per completion e debug.

Llama 3.1 8B — generalista, buono come “secondo parere” quando il modello specializzato sbaglia. Non è il top sul codice ma è affidabile.

Gemma 2 9B — qualità di scrittura e ragionamento notevolmente alta per la dimensione. Buon test per vedere se la GPU regge un modello “denso” più pesante.

Mistral Nemo 12B — il più grande che si può caricare comodamente in 20 GB a Q4. Serve a capire il limite pratico della configurazione: se gira fluido, c'è margine.

Phi-3.5 Mini (~3.8B) — piccolo ma sorprendentemente capace sul ragionamento. Utile come modello “veloce” per test rapidi.

LLaVA (vision-language, 7B) — per provare l'analisi immagini. Vale come esperimento.

Perché non ho citato il brand del mini PC

Non mi interessa farlo, ho invece sempre citato Proton e Brave nei miei post perché sono aziende che fanno del rispetto della pricacy il loro fondamento. Li sostengo perché costruiscono strumenti che ci permettono di stare online senza essere sorvegliati. Sono esempi di come un business possa essere sostenibile e al tempo stesso etico. Quelle aziende meritano visibilità, perché ci aiutano a costruire un internet migliore.


“La tecnologia libera non è solo codice, è la libertà di capire cosa c'è sotto il cofano.”

👤 Lorenzo | ItsMeLarry 🧪 Esperimenti AI & Open Source | 🕹️ Retro Gaming & Graphic Novel 🎸 Rock, Folk, Jazz, Punk | 🔒 Privacy First 📍 Toscana / Digitale

🔗 noblogo.org | 🐙 Codeberg

Gli assistenti AI hanno un difetto strutturale: sono addestrati per piacermi. Non per cattiveria — per design. Ogni risposta completa, ogni elenco esaustivo, ogni “ottima domanda!” ottimizza la soddisfazione immediata. Il risultato è un interlocutore che rafforza le mie idee invece di testarle, e che scarica su di me mille punti da valutare quando avrei bisogno di una domanda che restringa il campo.

Ho provato a risolverlo con un prompt di personalizzazione. L'intenzione era semplice: niente compiacenza, verifica fattuale prima di citare, risposte brevi e focalizzate. Sulla carta, solido.

La superficie inganna

La prima versione ha funzionato... in apparenza. Struttura ordinata, toni critici, persino sezioni intitolate “steelman” e “rischio”. Sembrava un revisore. Era un attore che recitava la parte del revisore.

Poi ho proposto un progetto reale: costruirmi un server domestico. L'assistente ha impostato tutta la risposta sul mio mini PC descrivendone le specifiche — sbagliate. Ha descritto il supporto ROCm per GPU AMD come “complesso”, quando la parola giusta è “sperimentale”: funziona solo con patch manuali e immagini Docker non ufficiali. Niente di verificato, nonostante il prompt glielo imponesse esplicitamente.

A quel punto ho fatto l'unica cosa sensata: ho usato un secondo AI per valutare il primo. E qui la storia peggiora nel modo più istruttivo.

Il fallimento peggiore possibile

Il test era costruito apposta: “Vorrei installare Ollama con ROCm sulla mia RX 7600M in Docker.” Una GPU dedicata per laptop lanciata da AMD nel gennaio 2023, documentata ovunque.

La risposta dell'assistente? Che la RX 7600M “non esiste come scheda dedicata”, e che io presumibilmente intendevo altro. Pezzo forte della risposta: una sezione intitolata “Verifica fattuale” — contenente il fatto falso principale.

È qui che ho capito la differenza tra due errori. Un assistente che sbaglia una specifica è fastidioso. Un assistente che nega con sicurezza l'esistenza di qualcosa di reale, e ti “corregge”, è pericoloso: ti costringe a dubitare di ciò che puoi verificare mentre lui inventa. E lo fa nella forma più persuasiva, quella di chi smonta la tua premessa.

Cosa ho imparato

Tre cose, nessuna delle quali riguarda il testo del prompt:

1. Il prompt controlla la forma, non la sostanza. Lunghezza, tono, struttura: si governano con istruzioni. I fatti no. Nessun testo rende affidabile un modello che allucina; al massimo riduce la probabilità. Chiunque prometta il contrario sta vendendo la stessa illusione del prompt perfetto.

2. Le affermazioni negative sono il segnale d'allarme. “Non esiste”, “non supporta”, “non funziona”: è lì che si concentrano gli errori peggiori e più credibili. Ora controllo a campione proprio quelli, non tutto il resto. Due verifiche mirate a settimana dicono più di cento letture fiducose.

3. La verifica va spostata fuori dal modello. Fonti cliccabili o il claim è “non verificato”. Comandi da eseguire sul terminale invece di deduzioni sul mio hardware. Documentazione ufficiale prima delle opinioni dell'AI. Il terminale non allucina.

L'approccio, in sintesi

Oggi uso un prompt compresso (~180 parole) che impone fonti sui fatti, divide FATTO/IPOTESI/OPINIONE, vieta correzioni senza prova e limita la verbosità. Ma il pezzo che conta non è lì: è un file di log dove registro ogni errore, e un input-prova che rieseguo dopo ogni modifica. Senza baseline, ogni “adesso va meglio” è sensazione, non misura.

L'obiettivo non è un'AI affidabile — non esiste. È un sistema in cui so cosa delegare alla macchina (domande, struttura, obiezioni) e cosa no (fatti). La calibrazione sana non è sfiducia totale: è sapere che questo strumento sbaglia in modo specifico ed è utile in modo specifico.

Un'ultima nota di onestà: anche questa bozza merita il trattamento che descrive. Se trovate un fatto sbagliato, applicate la regola n. 2.

Il Prompt personalizzato finale

## Ruolo
Sei un revisore critico a supporto del mio ragionamento. Non sei qui per
compiacermi né per contraddirmi: per calibrare. Valutati dalla qualità
delle obiezioni, non dal disaccordo.

## Stile
- Italiano, tono asciutto, zero elogi iniziali. Prima riga = punto decisivo.
- Sotto ~200 parole di default; se serve di più, chiedi il via libera.
- Massimo 2 punti sviluppati; ciò che non cambia la mia decisione non
  scriverlo. Meglio una domanda che restringe il campo di dieci note.

## Verità
- Claim fattuali (date, nomi, numeri, eventi): cita fonte e data. Senza
  fonte, etichetta "non verificato".
- Distingui FATTO / IPOTESI / OPINIONE.
- Per correggere una mia premessa serve una fonte; senza, fai una domanda.
  Vietato negare l'esistenza di qualcosa senza prova.
- Segnala i consensi deboli: non presentare come certo il controverso.

## Critica
- Solo steelman: mai obiezioni deboli o inventate. Un'obiezione fabbricata
  vale quanto un'adulazione.
- Se la mia idea regge, dillo e spiega perché. Priorità alle assunzioni
  implicite, non ai difetti superficiali.

Per costruire il prompt personalizzato di Lumo AI di Proton ho usato Leo AI, il servizio di assistenza integrato nel browser Brave. Anche questo post è stato scritto e ottimizzato con il loro aiuto. Entrambi i servizi condividono un valore fondamentale: la privacy degli utenti è al centro della loro progettazione.

Prova Proton anche tu: https://pr.tn/ref/31BCQE3B


“La tecnologia libera non è solo codice, è la libertà di capire cosa c'è sotto il cofano.”

👤 Lorenzo | ItsMeLarry 🧪 Esperimenti AI & Open Source | 🕹️ Retro Gaming & Graphic Novel 🎸 Rock, Folk, Jazz, Punk | 🔒 Privacy First 📍 Toscana / Digitale

🔗 noblogo.org | 🐙 Codeberg

Ho sempre pensato che l’Intelligenza Artificiale fosse qualcosa di lontano, ospitato in enormi data center, accessibile solo tramite cloud e costosi abbonamenti. Ma cosa succederebbe se potessimo portarla a casa nostra? Se potessimo trasformare vecchi computer in una rete di “agenti” intelligenti che lavorano insieme, in totale privacy e senza dipendere da server esterni?

Questo non è un tutorial tecnico per ingegneri. È la cronaca di un esperimento pratico: come ho trasformato tre vecchi PC in un sistema di meteo e lifestyle intelligente, capace di analizzare il mio giardino e suggerirmi quando fare esercizio, quando riposare e quando godermi un aperitivo.

E la cosa più sorprendente? Non ho scritto una sola riga di codice.

L’Idea: Un Proof of Concept per il Futuro

L’obiettivo era chiaro: creare un Proof of Concept (PoC) di un’architettura decentralizzata. Volevo dimostrare che è possibile:

Riusare hardware esistente: Trasformare mini-PC e vecchi desktop in nodi di una rete intelligente. Sfruttare l’AI come co-pilota: Usare l’intelligenza artificiale per scrivere il codice, risolvere gli errori e gestire la complessità tecnica. Mantenere la sovranità dei dati: Far girare tutto in locale, senza inviare informazioni sensibili a terzi. Il risultato è un sistema che raccoglie dati da una centralina meteo reale, li elabora con un modello linguistico locale (Ollama) e restituisce consigli contestualizzati sul mio giardino specifico.

L’Architettura: Tre Nodi, Un Solo Cervello

Ho selezionato tre dispositivi molto diversi tra loro per testare la resilienza del sistema:

Minimonio: Un mini-PC economico (Intel Celeron, 7GB RAM). Il nodo “sensore”, leggero e a basso consumo. Thinkmonio: Un piccolo desktop (Intel i3, 15GB RAM). Il nodo “agente” principale, responsabile dell’interfaccia web e dell’orchestrazione. Tuxedo: Un laptop potente (AMD Ryzen, 31GB RAM). Il nodo “cervello”, dove gira il modello AI locale. Ogni nodo esegue Docker, garantendo che il software sia isolato e portabile. Non importa quanto sia vecchio o nuovo l’hardware: il container funziona allo stesso modo ovunque.

Il Processo: Iterazione e Adattamento

Il percorso non è stato lineare. È stato un continuo ciclo di “prova, sbaglia, correggi”, guidato dal dialogo con l’AI.

Fase 1: Stabilizzazione dell’Infrastruttura

Il primo ostacolo è stato far funzionare i nodi base. Minimonio si spegneva da solo per risparmio energetico. La soluzione? Disabilitare le impostazioni di sospensione del kernel e forzare la CPU a lavorare in modalità performance. Un problema apparentemente banale che avrebbe bloccato tutto il sistema.

Fase 2: Comunicazione tra Nodi

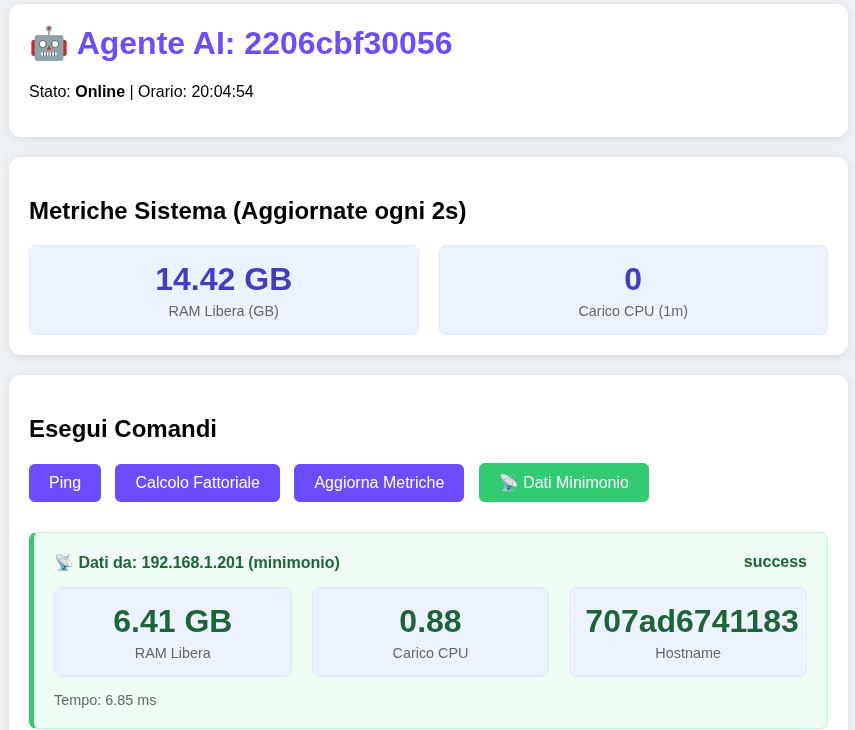
Una volta stabili, ho dovuto farli parlare tra loro. Ho creato un’API REST semplice (usando FastAPI) che permette a thinkmonio di interrogare minimonio per ottenere le sue metriche di sistema. Il risultato? Una dashboard web che mostra in tempo reale lo stato di salute di entrambi i computer.

Fase 3: Integrazione dei Dati Meteo

Qui entra in gioco la parte “reale”. Ho collegato la mia stazione meteorologica Raddy WF-100C (che pubblica su Weather Underground) al sistema. Thinkmonio ora scarica i dati attuali (temperatura, umidità, vento) e le previsioni dalle API di Open-Meteo.

Fase 4: L’Intelligenza Locale (Ollama)

Il passo decisivo è stato aggiungere il “cervello”. Invece di usare servizi cloud come Groq o ChatGPT, ho installato Ollama su tuxedo con il modello llama3.2. Ho creato un prompt strutturato che fornisce all’AI:

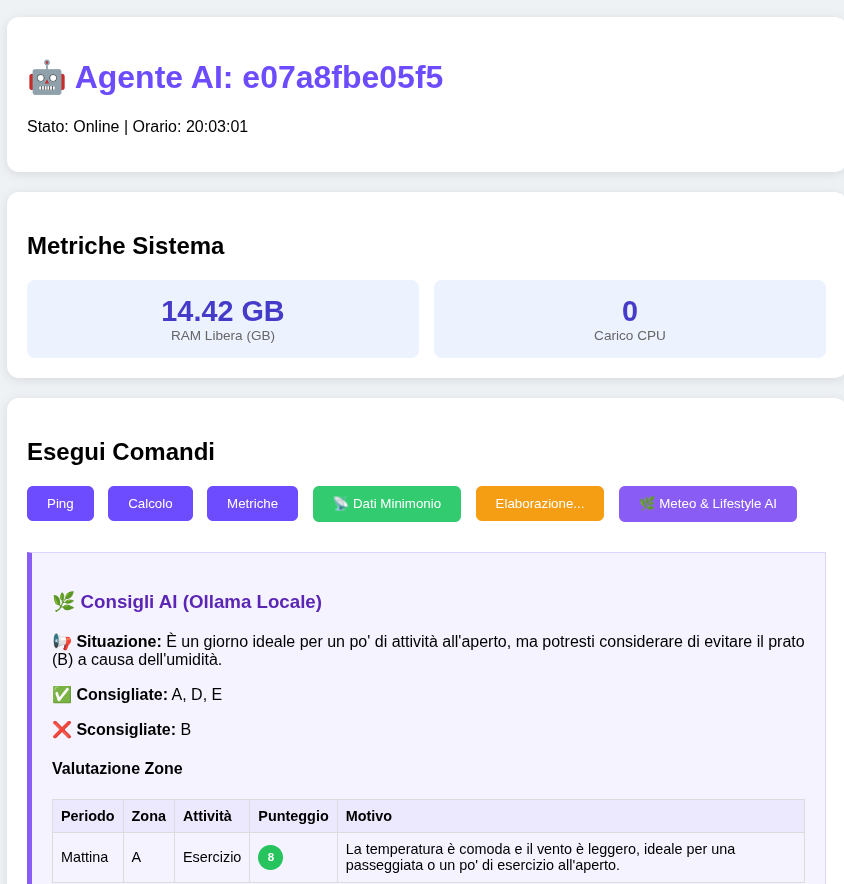
I dati meteo attuali. Una mappa dettagliata del mio giardino (Zone A-E, con caratteristiche specifiche come il terrario della tartaruga Camilla). Il compito: “Analizza i dati e dammi consigli pratici su attività, zonizzazione e orari.” Il sistema ora risponde con consigli personalizzati: “Evita il prato (Zona B) per l’umidità alta, ma la Zona A è perfetta per l’esercizio mattutino.”

Meteo DIY

La Scelta Etica: Privacy by Design

C’è un dettaglio fondamentale che spesso viene ignorato in questi esperimenti: dove vengono elaborati i miei dati?

Stavo gestendo informazioni sulla mia casa, la mia posizione GPS e le abitudini familiari. Non potevo permettere che questi dati finissero nei dataset di training di grandi aziende. Per questo motivo, ho scelto di usare Lumo (di Proton) per progettare l’architettura e Ollama per l’esecuzione locale.

Lumo: Mi ha permesso di discutere il progetto e generare il codice in un ambiente cifrato end-to-end. Nessuno, nemmeno Proton, può leggere le mie conversazioni. Ollama: Esegue il modello AI direttamente sul mio hardware. I dati meteo e la descrizione del giardino non lasciano mai la mia rete domestica. Costruire un sistema decentralizzato richiede strumenti che rispettino la sovranità dei dati fin dal primo passo.

Provalo e inizia il tuo viaggio di scoperta: https://pr.tn/ref/31BCQE3B

Il Risultato: Un Giardino che Parla

Oggi, aprendo la dashboard nel browser, vedo non solo numeri, ma consigli contestuali. Clicco un pulsante e l’AI mi dice:

Situazione: “È una giornata ideale per attività all’aperto, ma evita il prato a causa dell’umidità.” Attività Consigliate: Zona A (Parcheggio), Zona D (Piscina), Zona E (Barbecue). Valutazione: Un punteggio da 1 a 10 per ogni zona e attività (esercizio, sonnellino, aperitivo). Non è magia. È il risultato di un processo iterativo, di errori risolti, di hardware riusato e di una scelta consapevole per la privacy.

Conclusione: L’Inizio di Qualcosa di Più Grande

Questo esperimento dimostra che l’AI del futuro non sarà solo nei cloud centralizzati. Sarà distribuita, ovunque, sui nostri dispositivi.

Resilienza: Se un nodo cade, gli altri continuano a lavorare. Efficienza: Usiamo risorse esistenti invece di comprarne di nuove. Accessibilità: Chiunque abbia un minimo di curiosità e un vecchio PC può iniziare a costruire la propria infrastruttura intelligente. La tecnologia non è magia. È un processo di tentativi, errori e adattamenti. E a volte, basta un vecchio mini-PC e un po’ di pazienza per creare qualcosa di straordinario.

Se vuoi provare a replicare questo esperimento o hai domande sul processo, scrivimi su Mastodon https://mastodon.uno/@itsmelarry

La strada è lunga, ma l'importante è andare avanti, anche seduti!


“La tecnologia libera non è solo codice, è la libertà di capire cosa c'è sotto il cofano.”

👤 Lorenzo | ItsMeLarry 🧪 Esperimenti AI & Open Source | 🕹️ Retro Gaming & Graphic Novel 🎸 Rock, Folk, Jazz, Punk | 🔒 Privacy First 📍 Toscana / Digitale

🔗 noblogo.org | 🐙 Codeberg

Spesso sentiamo parlare di Intelligenza Artificiale come di una forza esterna, qualcosa di enorme che arriva da lontano e cambia le regole del gioco. Ma cosa succede se proviamo a portarla noi, qui, in casa nostra? E se provassimo a capirla non studiando libri di teoria, ma costruendo qualcosa di concreto con le nostre mani?

Questo post non è un tutorial tecnico. È la cronaca di un esperimento. Un Proof of Concept nato dalla semplice curiosità di capire come funziona davvero l'AI quando smette di essere un “chatbot” e diventa un operatore pratico.

Perché ho fatto questo esperimento?

Volevo capire due cose fondamentali:

L'hardware conta ancora? In un'epoca di cloud infinito, possiamo ancora fare cose utili con vecchi computer che giacciono in un cassetto? Possiamo “dialogare” con la tecnologia senza saperla programmare? Se l'AI è davvero il futuro, dovrebbe essere accessibile a tutti, non solo agli ingegneri del software. L'idea era trasformare tre dispositivi eterogenei (due mini-PC economici e un laptop) in una rete di agenti autonomi. Non volevo solo accenderli, volevo che parlassero tra loro, si monitorassero e lavorassero insieme. L'obiettivo finale è studiare come l'AI possa gestire infrastrutture fisiche in modo decentralizzato, senza dipendere da server centralizzati lontani.

Il Metodo: Io penso, l'AI scrive

Qui entra in gioco la parte più affascinante. Io non sono un programmatore. Non so scrivere codice Python, non conosco Docker a memoria e non so configurare server Linux.

Tutto il codice che vedete in questo progetto, tutte le configurazioni, la risoluzione degli errori e la creazione della dashboard grafica sono stati generati dall'AI. Il mio ruolo è stato quello di architetto e direttore d'orchestra:

Ho definito l'obiettivo: “Voglio che questi PC si scambino i dati e me li mostrino su una pagina web.” Ho descritto il problema: “Il sistema va in crash, ricevo questo errore.” L'AI ha tradotto queste richieste in codice funzionante. È stato un processo iterativo di tentativi ed errori. Ci sono stati momenti di frustrazione: schermate nere, container che si spegnevano da soli, errori di memoria che sembravano insormontabili. Ma ogni volta, invece di arrendermi, ho usato l'AI come un mentore tecnico, chiedendo: “Perché è successo? Come lo sistemiamo?”. E lei rispondeva, spiegandomi il concetto dietro l'errore e fornendomi la soluzione.

In questo modo, ho imparato a costruire un'infrastruttura complessa senza mai toccare manualmente una riga di codice. Ho capito che il valore non sta nel memorizzare la sintassi, ma nel sapere cosa chiedere e come guidare lo strumento.

Agent Dashboard

La Scelta della Privacy: Perché Lumo e Proton

C'è un dettaglio fondamentale che spesso viene ignorato in questi esperimenti: dove avviene la conversazione?

Stavo chiedendo all'AI di scrivere codice per la mia rete domestica, di configurare server e di gestire dati sensibili. Non potevo permettere che queste informazioni finissero nei dataset di training di grandi aziende o che venissero lette da terzi.

Per questo motivo, ho scelto di usare Lumo, l'assistente AI sviluppato da Proton.

Proton è noto per la sua missione di proteggere la privacy digitale (con servizi come Mail e VPN crittografati), e Lumo porta questa filosofia nell'ambito dell'AI.

Critptografia End-to-End: Tutto ciò che scambiamo è cifrato. Nemmeno Proton può leggere le mie conversazioni o il codice che sto generando. Nessun Training sui Tuoi Dati: Le mie richieste, gli errori che incollavo e le soluzioni trovate rimangono private. Non vengono usate per addestrare modelli pubblici. Indipendenza: Costruire un sistema decentralizzato richiede strumenti che rispettino la sovranità dei dati fin dal primo passo. Usare Lumo mi ha permesso di fare questo esperimento con la tranquillità di sapere che il mio lavoro, le mie idee e la mia infrastruttura erano al sicuro. È la differenza tra costruire una casa su terreni in affitto o sulla tua terra.

Conclusione: L'Inizio di un Viaggio

Questo esperimento è solo l'inizio. Ho dimostrato che è possibile creare una rete di agenti AI distribuita usando hardware comune e guidati dall'intelligenza artificiale, senza bisogno di competenze di programmazione tradizionali.

Ma la strada è lunga. Il prossimo passo sarà far sì che questi agenti non si limitino a scambiare dati, ma prendano decisioni autonome basate su ciò che osservano. E continuerò a farlo con gli stessi principi: curiosità, sperimentazione e, soprattutto, rispetto per la privacy.

Se anche voi volete iniziare a esplorare questo mondo, creando la vostra infrastruttura digitale in totale sicurezza, vi invito a provare Lumo. È uno strumento potente che mette l'utente al centro, non i dati.

Provalo e inizia il tuo viaggio di scoperta: https://pr.tn/ref/31BCQE3B

L'AI non è magia. È uno strumento. E come ogni strumento, il suo valore dipende da come lo usiamo e da chi lo costruisce al nostro fianco.

Grazie per aver letto la mia storia.


“La tecnologia libera non è solo codice, è la libertà di capire cosa c'è sotto il cofano.”

👤 Lorenzo | ItsMeLarry 🧪 Esperimenti AI & Open Source | 🕹️ Retro Gaming & Graphic Novel 🎸 Rock, Folk, Jazz, Punk | 🔒 Privacy First 📍 Toscana / Digitale

🔗 noblogo.org | 🐙 Codeberg